蜗窝科技

内存初始化(上)

linuxer · · 内存管理 · 阅读 44446 · 2016年10月存档

一、前言

一直以来,我都非常着迷于两种电影拍摄手法:一种是慢镜头,将每一个细节全方位的展现给观众。另外一种就是快镜头,多半是反应一个时代的变迁,从非常长的时间段中,截取几个典型的snapshot,合成在十几秒的镜头中,可以让观众很快的了解一个事物的发展脉络。对应到技术层面,慢镜头有点类似情景分析,把每一行代码都详细的进行解析,了解技术的细节。快镜头类似数据流分析,勾勒一个过程中,数据结构的演化。本文采用了快镜头的方法,对内存初始化部分进行描述,不纠缠于具体函数的代码实现,只是希望能给大家一个概略性的印象(有兴趣的同学可以自行研究代码)。BTW,在本文中我们都是基于ARM64来描述体系结构相关的内容。

二、启动之前

在详细描述linux kernel对内存的初始化过程之前,我们必须首先了解kernel在执行第一条语句之前所面临的处境。这时候的内存状况可以参考下图:
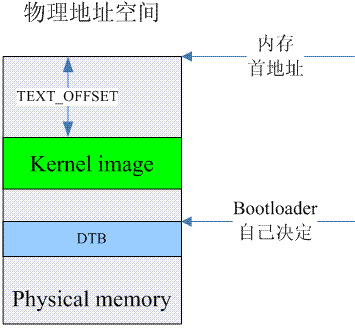
bootloader有自己的方法来了解系统中memory的布局,然后,它会将绿色的kernel image和蓝色dtb image copy到了指定的内存位置上。kernel image最好是位于main memory起始地址偏移TEXT_OFFSET的位置,当然,TEXT_OFFSET需要和kernel协商好。kernel image是否一定位于起始的main memory(memory address最低)呢?也不一定,但是对于kernel而言,低于kernel image的内存,kernel是不会纳入到自己的内存管理系统中的。对于dtb image的位置,linux并没有特别的要求。由于这时候MMU是turn off的,因此CPU只能看到物理地址空间。对于cache的要求也比较简单,只有一条:kernel image对应的cache必须clean to PoC,即系统中所有的observer在访问kernel image对应内存地址的时候是一致性的。

三、汇编时代

一旦跳转到linux kernel执行,内核则完全掌控了内存系统的控制权,它需要做的事情首先就是要打开MMU,而为了打开MMU,必须要创建linux kernel正常运行需要的页表,这就是本节的主要内容。

在体系结构相关的汇编初始化阶段,我们会准备二段地址的页表:一段是identity mapping,其实就是把地址等于物理地址的那些虚拟地址mapping到物理地址上去,打开MMU相关的代码需要这样的mapping(别的CPU不知道,但是ARM ARCH强烈推荐这么做的)。第二段是kernel image mapping,内核代码欢快的执行当然需要将kernel running需要的地址(kernel txt、rodata、data、bss等等)进行映射了。具体的映射情况可以参考下图:
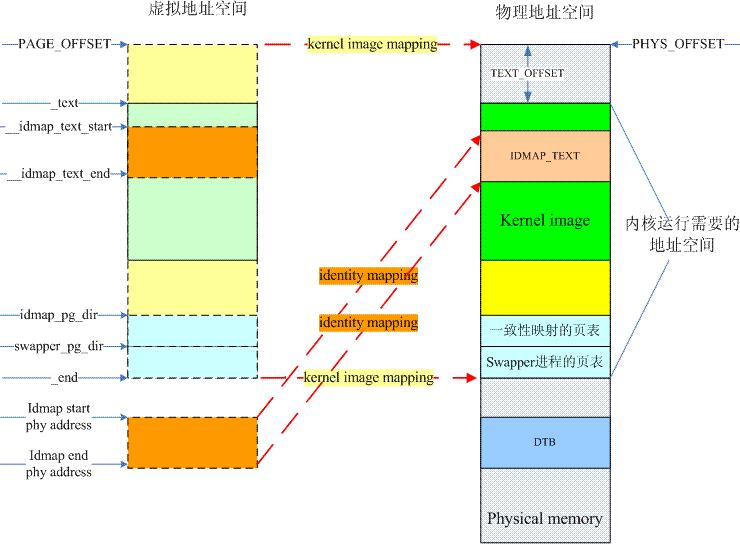
turn on MMU相关的代码被放入到一个特别的section,名字是.idmap.text,实际上对应上图中物理地址空间的IDMAP_TEXT这个block。这个区域的代码被mapping了两次,做为kernel image的一部分,它被映射到了__idmap_text_start开始的虚拟地址上去,此外,假设IDMAP_TEXT block的物理地址是A地址,那么它还被映射到了A地址开始的虚拟地址上去。虽然上图中表示的A地址似乎要大于PAGE_OFFSET,不过实际上不一定需要这样的关系,这和具体处理器的实现有关。

编译器感知的是kernel image的虚拟地址(左侧),在内核的链接脚本中定义了若干的符号,都是虚拟地址。但是在内核刚开始,没有打开MMU之前,这些代码实际上是运行在物理地址上的,因此,内核起始刚开始的汇编代码基本上是PIC的,首先需要定位到页表的位置,然后在页表中填入kernel image mapping和identity mapping的页表项。页表的起始位置比较好定(bss段之后),但是具体的size还是需要思考一下的。我们要选择一个合适的size,确保能够覆盖kernel image mapping和identity mapping的地址段,然后又不会太浪费。我们以kernel image mapping为例,描述确定Tranlation table size的思考过程。假设48 bit的虚拟地址配置,4k的page size,这时候需要4级映射,地址被分成9(level 0 or PGD) + 9(level 1 or PUD) + 9(level 2 or PMD) + 9(level 3 or PTE) + 12(page offset),假设我们分配4个page分别保存Level 0到level 3的translation table,那么可以建立的最大的地址映射范围是512(level 3中有512个entry) X 4k = 2M。2M这个size当然不理想,无法容纳kernel image的地址区域,怎么办?使用section mapping,让PMD执行block descriptor,这样使用3个page就可以mapping 512 X 2M = 1G的地址空间范围。当然,这种方法有一点副作用就是:PAGE_OFFSET必须2M对齐。对于16K或者64K的page size,使用section mapping就有点不合适了,因为这时候对齐的要求太高了,对于16K page size,需要32M对齐,对于64K page size,需要512M对齐。不过,这也没有什么,毕竟这时候page size也变大了,不使用section mapping也能覆盖很大区域。例如,对于16K page size,一个16K page size中可以保存2K个entry,因此能够覆盖2K X 16K = 32M的地址范围。对于64K page size,一个64K page size中可以保存8K个entry,因此能够覆盖8K X 64K = 512M的地址范围。32M和512M基本是可以满足需求的。最后的结论:swapper进程(内核空间)需要预留页表的size是和page table level相关,如果使用了section mapping,那么需要预留PGTABLE_LEVELS - 1个page。如果不使用section mapping,那么需要预留PGTABLE_LEVELS 个page。

上面的结论起始是适合大部分情况下的identity mapping,但是还是有特例(需要考虑的点主要和其物理地址的位置相关)。我们假设这样的一个配置:虚拟地址配置为39bit,而物理地址是48个bit,同时,IDMAP_TEXT这个block的地址位于高端地址(大于39 bit能表示的范围)。在这种情况下,上面的结论失效了,因为PGTABLE_LEVELS 是和虚拟地址的bit数、PAGE_SIZE的定义相关,而是和物理地址的配置无关。linux kernel使用了巧妙的方法解决了这个问题,大家可以自己看代码理解,这里就不多说了。

一旦设定完了页表,那么打开MMU之后,kernel正式就会进入虚拟地址空间的世界,美中不足的是内核的虚拟世界没有那么大。原来拥有的整个物理地址空间都消失了,能看到的仅仅剩下kernel image mapping和identity mapping这两段地址空间是可见的。不过没有关系,这只是刚开始,内存初始化之路还很长。

四、看见DTB

虽然可以通过kernel image mapping和identity mapping来窥探物理地址空间,但终究是管中窥豹,不了解全局,那么内核是如何了解对端的物理世界呢?答案就是DTB,但是问题来了,这时候,内核还没有为DTB这段内存创建映射,因此,打开MMU之后的kernel还不能直接访问,需要先创建dtb mapping,而要创建address mapping,就需要分配页表内存,而这时候,还没有了解内存布局,内存管理模块还没有初始化,如何来分配内存呢?

下面这张图片给出了解决方案:
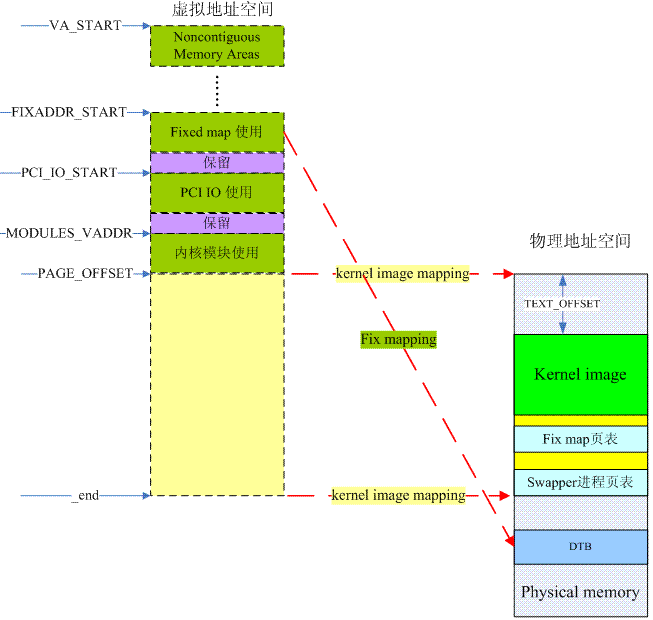
整个虚拟地址空间那么大,可以被平均分成两半,上半部分的虚拟地址空间主要各种特定的功能,而下半部分主要用于物理内存的直接映射。对于DTB而言,我们借用了fixed-mapped address这个概念。fixed map是被linux kernel用来解决一类问题的机制,这类问题的共同特点是:(1)在很早期的阶段需要进行地址映射,而此时,由于内存管理模块还没有完成初始化,不能动态分配内存,也就是无法动态分配创建映射需要的页表内存空间。(2)物理地址是固定的,或者是在运行时就可以确定的。对于这类问题,内核定义了一段固定映射的虚拟地址,让使用fix map机制的各个模块可以在系统启动的早期就可以创建地址映射,当然,这种机制不是那么灵活,因为虚拟地址都是编译时固定分配的。

好,我们可以考虑创建第三段地址映射了,当然,要创建地址映射就要创建各个level中描述符。对于fixed-mapped address这段虚拟地址空间,由于也是位于内核空间,因此PGD当然就是复用swapper进程的PGD了(其实整个系统就一个PGD),而其他level的Translation table则是静态定义的(arch/arm64/mm/mmu.c),位于内核bss段,由于所有的Translation table都在kernel image mapping的范围内,因此内核可以毫无压力的访问,并创建fixed-mapped address这段虚拟地址空间对应的PUD、PMD和PTE的entry。所有中间level的Translation table都是在early_fixmap_init函数中完成初始化的,最后一个level则是在各个具体的模块进行的,对于DTB而言,这发生在fixmap_remap_fdt函数中。

系统对dtb的size有要求,不能大于2M,这个要求主要是要确保在创建地址映射(create_mapping)的时候不能分配其他的translation table page,也就是说,所有的translation table都必须静态定义。为什么呢?因为这时候内存管理模块还没有初始化,即便是memblock模块(初始化阶段分配内存的模块)都尚未初始化(没有内存布局的信息),不能动态分配内存。

五、early ioremap

除了DTB,在启动阶段,还有其他的模块也想要创建地址映射,当然,对于这些需求,内核统一采用了fixmap的机制来应对,fixmap的具体信息如下图所示:
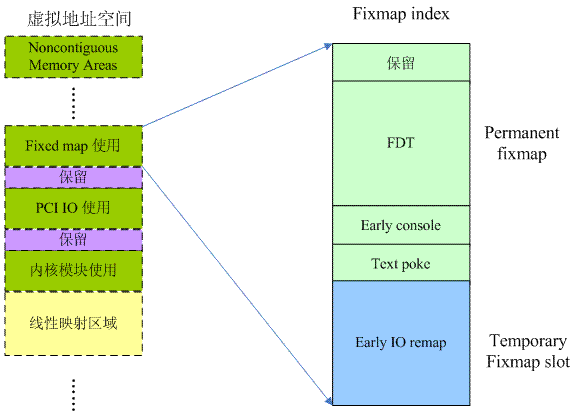
从上面这个图片可以看出fix-mapped虚拟地址分成两段,一段是permanent fix map,一段是temporary fixmap。所谓permanent表示映射关系永远都是存在的,例如FDT区域,一旦完成地址映射,内核可以访问DTB之后,这个映射关系一直都是存在的。而temporary fixmap则不然,一般而言,某个模块使用了这部分的虚拟地址之后,需要尽快释放这段虚拟地址,以便给其他模块使用。

你可能会很奇怪,因为传统的驱动模块中,大家通常使用ioremap函数来完成地址映射,为了还有一个early IO remap呢?其实ioremap函数的使用需要一定的前提条件的,在地址映射过程中,如果某个level的Translation tabe不存在,那么该函数需要调用伙伴系统模块的接口来分配一个page size的内存来创建某个level的Translation table,但是在启动阶段,内存管理的伙伴系统还没有ready,其实这时候,内核连系统中有多少内存都不知道的。而early io remap则在early_ioremap_init之后就可以被使用了。更具体的信息请参考mm/early_ioremap.c文件。

结论:如果想要在伙伴系统初始化之前进行设备寄存器的访问,那么可以考虑early IO remap机制。

六、内存布局

完成DTB的映射之后,内核可以访问这一段的内存了,通过解析DTB中的内容,内核可以勾勒出整个内存布局的情况,为后续内存管理初始化奠定基础。收集内存布局的信息主要来自下面几条途径:

(1)choosen node。该节点有一个bootargs属性,该属性定义了内核的启动参数,而在启动参数中,可能包括了mem=nn[KMG]这样的参数项。initrd-start和initrd-end参数定义了initial ramdisk image的物理地址范围。

(2)memory node。这个节点主要定义了系统中的物理内存布局。主要的布局信息是通过reg属性来定义的,该属性定义了若干的起始地址和size条目。

(3)DTB header中的memreserve域。对于dts而言,这个域是定义在root node之外的一行字符串,例如:/memreserve/ 0x05e00000 0x00100000;,memreserve之后的两个值分别定义了起始地址和size。对于dtb而言,memreserve这个字符串被DTC解析并称为DTB header中的一部分。更具体的信息可以参考device tree基础文档,了解DTB的结构。

(4)reserved-memory node。这个节点及其子节点定义了系统中保留的内存地址区域。保留内存有两种,一种是静态定义的,用reg属性定义的address和size。另外一种是动态定义的,只是通过size属性定义了保留内存区域的长度,或者通过alignment属性定义对齐属性,动态定义类型的子节点的属性不能精准的定义出保留内存区域的起始地址和长度。在建立地址映射方面,可以通过no-map属性来控制保留内存区域的地址映射关系的建立。更具体的信息可以阅读参考文献[1]。

通过对DTB中上述信息的解析,其实内核已经基本对内存布局有数了,但是如何来管理这些信息呢?这也就是著名的memblock模块,主要负责在初始化阶段用来管理物理内存。一个参考性的示意图如下:

内核在收集了若干和memory相关的信息后,会调用memblock模块的接口API(例如:memblock_add、memblock_reserve、memblock_remove等)来管理这些内存布局的信息。内核需要动态管理起来的内存资源被保存在memblock的memory type的数组中(上图中的绿色block,按照地址的大小顺序排列),而那些需要预留的,不需要内核管理的内存被保存在memblock的reserved type的数组中(上图中的青色block,也是按照地址的大小顺序排列)。要想了解进一步的信息,请参考内核代码中的setup_machine_fdt和arm64_memblock_init这两个函数的实现。

七、看到内存

了解到了当前的物理内存的布局,但是内核仍然只是能够访问部分内存(kernel image mapping和DTB那两段内存,上图中黄色block),大部分的内存仍然处于黑暗中,等待光明的到来,也就是说需要创建这些内存的地址映射。

在这个时间点上,创建内存的地址映射有一个悖论:创建地址映射需要分配内存,但是这时候伙伴系统没有ready,无法动态分配。也许你会说,memblock不是已经ready了吗,不可以调用memblock_alloc进行物理内存的分配吗?当然可以,memblock_alloc分配的物理内存仍然需要通过虚拟地址访问,而这些内存都还没有创建地址映射,因此内核一旦访问memblock_alloc分配的物理内存,悲剧就会发生了。

怎么办呢?内核采用了一个巧妙的办法:那就是控制创建地址映射,memblock_alloc分配页表内存的顺序。也就是说刚开始的时候创建的地址映射不需要页表内存的分配,当内核需要调用memblock_alloc进行页表物理地址分配的时候,很多已经创建映射的内存已经ready了,这样,在调用create_mapping的时候不需要分配页表内存。更具体的解释参考下面的图片:
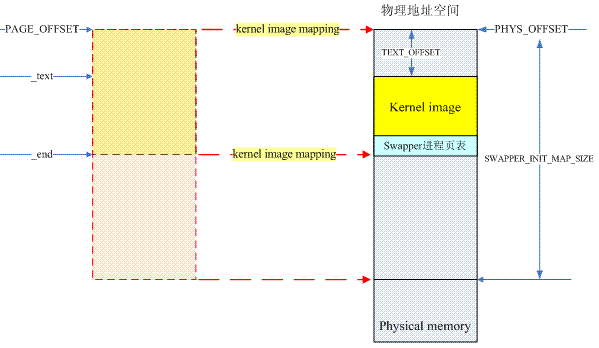
我们知道,在内核编译的时候,在BSS段之后分配了几个page用于swapper进程地址空间(内核空间)的映射,当然,由于kernel image不需要mapping那么多的地址,因此swapper进程translation table的最后一个level中的entry不会全部的填充完毕。换句话说:swapper进程页表可以支持远远大于kernel image mapping那一段的地址区域,实际上,它可以支持的地址段的size是SWAPPER_INIT_MAP_SIZE。为(PAGE_OFFSET,PAGE_OFFSET+SWAPPER_INIT_MAP_SIZE)这段虚拟内存创建地址映射,mapping到(PHYS_OFFSET,PHYS_OFFSET+SWAPPER_INIT_MAP_SIZE)这段物理内存的时候,调用create_mapping不会发生内存分配,因为所有的页表都已经存在了,不需要动态分配。

一旦完成了(PHYS_OFFSET,PHYS_OFFSET+SWAPPER_INIT_MAP_SIZE)这段物理内存的地址映射,这时候,终于可以自由使用memblock_alloc进行内存分配了,当然,要进行限制,确保分配的内存位于(PHYS_OFFSET,PHYS_OFFSET+SWAPPER_INIT_MAP_SIZE)这段物理内存中。完成所有memory type类型的memory region的地址映射之后,可以解除限制,任意分配memory了。而这时候,所有memory type的地址区域(上上图中绿色block)都已经可见,而这些宝贵的内存资源就是内存管理模块需要管理的对象。具体代码请参考paging_init—>map_mem函数的实现。

八、结束语

目前为止,所有为内存管理做的准备工作已经完成:收集了整个内存布局的信息,memblock模块中已经保存了所有需要管理memory region的信息,同时,系统也为所有的内存(reserved除外)创建了地址映射。虽然整个内存管理系统没有ready,但是通过memblock模块已经可以在随后的初始化过程中进行动态内存的分配。 有了这些基础,随后就是真正的内存管理系统的初始化了,我们下回分解。

参考文献:

1、Documentation/devicetree/bindings/reserved-memory/reserved-memory.txt

2、linux4.4.6内核代码

标签:初始化内存管理

继续讨论

新讨论请用 GitHub 账号在下方发言——评论会保存在本仓库的 Discussions 里,与站点同寿; 再下方的「历史评论」是原站的只读存档。

评论(43 条,只读存档)

以下为原站的历史评论(只读存档);继续讨论请用上方的评论区。

  • coray

    好文章,一直很喜欢你的文章。 这些地方估计写错了: 在体系结构相关的汇编初始化阶段,我们会准备二段地址的页表:一段是identity mapping,其实就是把物理地址mapping到**物理地址**上去 kernel txt、**dernel** rodata、data、bss等等 **做为**kernel image的一部
  • coray

    nice,一直很喜欢你的文章,十分期待更新哦。 这些地方估计写错了: 在体系结构相关的汇编初始化阶段,我们会准备二段地址的页表:一段是identity mapping,其实就是把物理地址mapping到**物理地址**上去 kernel txt、**dernel** rodata、data、bss等等 **做为**kernel image的一部
    • linuxer

      @coray:多谢指正,关于identity mapping,更准确的说法应该是把地址等于物理地址的那些虚拟地址映射到物理地址上去,这样说起来有些拗口,所以我就简化成了“物理地址”到物理地址的mapping,呵呵~~~
  • HZM

    终于看到内存方面的了.. 楼主内存方面的文章,有无打算写程序编译和链接过程呀。。 个人觉得内存管理和程序的编译链接 两者关系挺密切
    • linuxer

      @HZM:后面写进程地址空间的时候应该会写到的。
  • lucky

    Hi linuxer,下面是我本地的一个dts,前两个memreserve含义比较明显,第三和第四个也是base和size的规则吗?算了一下不一样啊,这个alignment怎么看啊? /* memory reserved for SMEM */ /memreserve/ 0x87800000 0x500000; /* Offset:120M, Size:5M */ /* memory reserved for LTE modem */ /memreserve/ 0x89600000 0x3E80000; /* Offset:150M, Size:62.5M*/ /* memory reserved for fb */ /memreserve/ 0x9ED74000 0xA8C000; /* 480*854*4*3, 4K alignment*/ /* memory reserved for ION */ /memreserve/ 0x9F800000 0x800000; /* 480*854*4*2, 8K alignment */ /include/ "skeleton.dtsi" /include/ "scx35l-sp9830ied-clocks.dtsi" /include/ "sc2723-regulators.dtsi" /include/ "sprd-sound.dtsi" /include/ "sprd-battery.dtsi" / { model = "Spreadtrum SP8835EB board"; compatible = "sprd,sp8835eb"; sprd,sc-id = <8830 1 0x20000>; #address-cells = <1>; #size-cells = <1>; interrupt-parent = <&gic>; chosen { bootargs = "loglevel=1 console=ttyS1,115200n8 init=/init root=/dev/ram0 rw androidboot.hardware=sc8830"; linux,initrd-start = <0x85500000>; linux,initrd-end = <0x855a3212>; }; memory: memory { device_type = "memory"; reg = <0x80000000 0x40000000>; }; setup_arch arm_memblock_init setup_arch early_init_fdt_scan_reserved_mem 识别 "reserved-memory"字段解析 //我看代码里识别"reserved-memory",但是dts里面都是memreserve的字段,这个是怎么解析的啊? 问题可能比较浅显,还请指导。。谢谢
    • linuxer

      @lucky:fdt_get_mem_rsv解析memreserve(位于dtb header中,不是node) __fdt_scan_reserved_mem解析reserved-memory node
  • HZM

    Hello,linuxer 请教一个问题,可能对你比较简单,但是我百思不得其解 Linux中的各个驱动是在进程的上下文里面执行的吗,如果是,在哪个进程 谢谢。
    • linuxer

      @HZM:谢谢你的问题,不过我建议你去讨论区去提问。之所以想这样做,主要是为了复用已经后续查找方便。 其实你这个问题我已经在某片博文下面中回答过了,当然,我不记得是在哪一篇了。也就是说,博文下面的交互其实很难检索。今天我在这样一篇讲内存的博文下面回答了你这个驱动上下文的问题,过一段时间后,其实很难找回这个问答咨询。当其他人问起这个问题的时间,我只能再一次重复回答,呵呵~~~这也是我为什么建议你去讨论区提问,见谅!
  • electrlife

    对于mmu不太熟,所以从elf角度思考且有些不解。 我理解: bootloaderr把image 搬运到物理内存里,此时mmu, cache等都是关闭的。此时的image是一个包含代码段数据段ZI段的binary。因此kernle首要任务是把此elf的binary中的各个section/segment映射到相应的虚拟空间上去。 Q1.这些虚拟的地址应该是在编译时就确定的,比如text section,在编译时就确认了其虚拟地址。 所以我们需要把这些虚拟地址映射到对应的物理地址上? Q2.建立这些映射,需要建立其相应的页表,而页表也需要内存空间,依据您的描述,我的理解这此空间是位于elf binary 的bss段之后,其size是可以使其能够映射所有的elf binary所需的虚拟空间即可? Q3.您文章中所提到的 kernel image mapping 是不是指的就是整个elf binary的映射(包括RO,RW,ZI,etc) ? Q4.假设我们此时已经把整个elf binary (kernle image)映射到了相应的虚拟空间去,我们知道程序运行需要一些额外的环境的建立, 如RW段的搬运,ZI段的初始化,那其实我们已经映射其需要的虚拟地址上,是不是也就意味着这些动作就不需要执行了? Q5. 依据您的描述我的理解在刚刚init时,物理空间布局如下,想了解下为何swapper process所需的空间有如此重要的地位?在这么早的阶段就需要静态的进行映射? +------------------------------+ | | | elf binary (kernel image) | | | +------------------------------+ | page tables (elf binary) | +------------------------------+ | page tables (fixed mapping) | +------------------------------+ | page tables (swapper process)| +------------------------------+
    • linuxer

      @electrlife:Q1:内核开始阶段的代码是PIC的,copy到任何的位置都可以正确的执行 Q2:是的,不过elf binary使用的不准确,kernel elf binary不包括bss段以及之后的page table这样的特殊section,因此,准确的说,静态定义的page table只要能完成kernel image mapping(链接脚本中的_text符号到_end符号)就OK了 Q3:kernel image mapping一定是覆盖elf binary,不过不仅仅是elf binary,还有bss段和静态定义的页表区 Q4:一旦完成了地址映射(填充好了页表内容、打开了MMU),那么kernel已经在其虚拟地址空间中欢快运行(编译就是按照虚拟地址编的),你说的那些RW段的搬运,ZI段的初始化应该都是不需要的,BTW,我感觉你是搞cortex M系列处理器的,RW ZI这些术语不属于GNU GCC,应该是realview那套编译环境的 Q5:swapper process就是内核,swapper process地址空间就是内核地址空间。
      • electrlife

        @linuxer:哈哈, ===>>> BTW,我感觉你是搞cortex M系列处理器的 这都被你看出来了,确实做了几年的MCU开发,基本都是cortex-m系列 ===>>> Q5:swapper process就是内核,swapper process地址空间就是内核地址空间。 +------------------------------+ | | | elf binary (kernel image) | | | +------------------------------+ | page tables (elf binary) | +------------------------------+ | page tables (fixed mapping) | +------------------------------+ | page tables (swapper process)| +------------------------------+ 您的意思是(page tables (swapper process))存放的是内核空间映射虚拟地址所需要的page tables? 我理解的内核空间(例如,1:3)指的是最高虚拟地址的那1G的空间? 如果是这样,是不是可以理解内核空间映射所需要的所有page tables都被安排在这段物理内存上? 感觉这和我理解的不一样,难道内核空间的内存不是使用是动态的进行映射的嘛?如果这样静态的映射如何确认所需的物理空间的大小? 问题比较撒哈,见谅! :-)
        • linuxer

          @electrlife:不是的,所有的内核线程共享一个地址空间,如下: struct mm_struct init_mm = { .mm_rb = RB_ROOT, .pgd = swapper_pg_dir, .mm_users = ATOMIC_INIT(2), .mm_count = ATOMIC_INIT(1), .mmap_sem = __RWSEM_INITIALIZER(init_mm.mmap_sem), .page_table_lock = __SPIN_LOCK_UNLOCKED(init_mm.page_table_lock), .mmlist = LIST_HEAD_INIT(init_mm.mmlist), INIT_MM_CONTEXT(init_mm) }; ---------------- 整个内核空间的页表当然是一个树状结构,其根在swapper_pg_dir,初始阶段,静态定义的页表只有几个page,这时候,pgd中有一个entry,指向静态定义的PUD,PUD中有一个entry,指向静态定义的PMD。如果是section mapping,那么到PMD就OK了,PMD中有若干个描述符,完成初始阶段kernel img mapping。 因此,刚开始,内核空间的页表就几个,更广阔的地址空间mapping是随着初始化的不断进行而慢慢建立的。
  • electrlife

    所有中间level的Translation table都是在early_fixmap_init函数中完成初始化的,最后一个level则是在各个具体的模块进行的,对于DTB而言,这发生在fixmap_remap_fdt函数中. ===>>> 想知道为什么最后一个Level要到具体的模块内进行映射,对于DTB而言,直接在early_fixmap_init时行映射不就可以了,这样分成两步来做,是须的吗?或是说有什么优点吗?
    • wowo

      @electrlife:这里体现的思想是:自己的memory,自己映射。early_fixmap_init怎么会知道到底要映射多少东西呢?比如我想映射一个GPIO的I/O空间点一个LED,也让early_fixmap_init帮忙吗?
  • MDO3054

    以下是我调试时的函数调用关系,内核打开了DEBUG_LL配置: start_kernel early_print("setup_arch()\n") setup_arch early_print("setup_machine_fdt()\n") mdesc = setup_machine_fdt(__atags_pointer) ... .... early_fixmap_init() early_ioremap_init() 很明显,在early_fixmap_init()前,我就在使用early_print()打印了,这个时候也是用的串口的虚拟地址,那这个串口的虚拟地址是不需要early_ioremap()吗?另外,这个uart的内存映射是在哪里做的呢?
    • linuxer

      @MDO3054:early_print的代码如下(arm平台,3.18.12): void __init early_print(const char *str, ...) { extern void printascii(const char *); char buf[256]; va_list ap; va_start(ap, str); vsnprintf(buf, sizeof(buf), str, ap); va_end(ap); #ifdef CONFIG_DEBUG_LL printascii(buf); #endif printk("%s", buf); } 如果early_print在early_ioremap_init之后,那么early_print不太可能是操作UART的虚拟地址,因为还没有mapping。代码中,printk实际上是输出到log buffer,而printascii是汇编写的,我记得是初始化阶段的调试方法,应该是操作UART的物理地址完成的。
      • MDO3054

        @linuxer:1、为啥early_ioremap_init之后,反而不可能操作虚拟地址?start_kernel前就已经开启MMU了,到这里应该全部都是虚拟地址了吧? 2、printascii()最后会调用arch/arm/include/xxx.S里的addruart宏: .macro addruart, rp, rv, tmp ldr \rp, =LL_UART_PADDR @ physical ldr \rv, =LL_UART_VADDR @ virtual .endm 该宏貌似用的就是虚拟地址?
        • linuxer

          @MDO3054:呵呵,写错了,如果early_print在early_ioremap_init之前,那么early_print不太可能是操作UART的虚拟地址。 其实printascii用什么地址我不关心,反正打开MMU之后,就不能直接操作UART物理地址了,而想要使用UART的物理地址,那么必须要mapping。如果printascii使用虚拟地址,那么一定在调用early_print之前就进行了UART io地址的mapping了。
  • Zhenhua

    而那些需要预留的,不需要内核管理的内存被保存在memblock的reserved type的数组中(上图中的青色block,也是按照地址的大小顺序排列) >>>觉得这个说法有问题啊,其实加进reserved type的memory也是会被map的,也会被内核管理。真正不需要管理的是带no-map属性,就是只在memory type中被除去的。。请指正?
    • linuxer

      @Zhenhua:你说的是对的。不过我这里“不需要内核管理”是指不需要进入“伙伴系统”
  • mm

    hi linuxer, 想要请教一下,我没有理解 identity mapping 的意思。 1. VA_START 是 kernel 虚拟地址空间的起始, 2. PAGE_OFFSET 是映射 kernel image 的虚拟地址空间的起始, 假设 VA_BITS / CONFIG_ARM64_VA_BITS 为 39, VA_START = (0xffff ffff ffff ffff UL) << 39, 也就是 0xffff ff80 0000 0000 PAGE_OFFSET = (0xffff ffff ffff ffff UL) << 38, 也就是 0xffff ffc0 0000 0000 也就是 PAGE_OFFSET 将内核虚拟地址空间对半分的意思,PAGE_OFFSET 往上放 kernel image, VA_START -> PAGE_OFFSET 中靠近 PAGE_OFFSET 的地方放 FIXED_MAP 映射所需的虚拟地址空间,用来做后面映射 DTB 时所需。 那么,kernel image mapping 就是 PAGE_OFFSET 映射到 __PHYS_OFFSET(我的理解 __PHYS_OFFSET 就是可以看着是物理地址 0 地址?) 请问 identity mapping 的意思就是 __PHYS_OFFSET(假设为 0),也要映射到虚拟地址空间的 0 地址的意思吗?还有个问题,从 bootloader 转过来调到 stext 后,一直没有看见重新设置 sp, 那就是说使用的栈一直没有变化,identity mapping 是考虑到这个吗?为什么 mapping 后不考虑重设栈起始呢?tks!
    • mm

      @mm:哦哦,明白了。 其实文章里面已经很明确地说明了是 enable_mmu 需要的。enable_mmu 还有一些别的函数放在 .idmap.text 这个 section 里面,要对这个 section 做特殊的处理,所以要 VA 和 PA 相等。 kernel image mapping 当然也要,不过不要求 VA 和 PA 相等了。 __PHYS_OFFSET 就是个地址值,KERNEL_START - TEXT_OFFSET, 其实更像虚拟地址。
    • 伊斯科明

      @mm:#define VA_START (UL(0xffffffffffffffff) - \ (UL(1) << VA_BITS) + 1) 当VA_BITS=39时,VA_START=0xFFFFFF0000000000 而, #define PAGE_OFFSET (UL(0xffffffffffffffff) - \ (UL(1) << (VA_BITS - 1)) + 1) 当VA_BITS=39时,PAGE_OFFSET=0xFFFFFF8000000000 从System.map可以看到: ffffff8009080000 T _text 所以_text是比PAGE_OFFSET地址大的。代码基于4.9.113
      • 伊斯科明

        @伊斯科明:囧,回复错人了
  • nzg

    hi linuxer, 有个疑问请教一下,如果当前VA_BITS=39; VA_START=0xffffff8000000000, PAGE_OFFSET=0xffffffc000000000, 而PAGE_OFFSET是kerme image 虚拟起始地址,_text算出 等于0xffffff8008080000(代码中是基于VA_START计算的), _text不是应该大于 PAGE_OFFSET才对吗?这怎么理解呢? 谢谢
    • mm

      @nzg:你看的是什么版本?如果是 4.4 之后的版本,在这里映射完成后,后面还会重新映射一次, setup_arch->paging_init->map_kernel 那,改到用 vmalloc 区域来管理映射了。 /memory_management/436.html 这里也有讲。 当然这里最初启动期间的映射还是线性的(kernel image 的地址段映射对应物理内存放置地址段),只是说 kernel 映射的虚拟地址区域不再是线性映射区域了,而是放到了 VMALLOC 区域。不过不知道 kernel 是哪个具体版本引入这个改动的,原因又是什么。 另外,映射 kernel image 的虚拟起始地址也不再是 PAGE_OFFSET, 而是 KIAMGE_VADDR + TEXT_OFFSET。 PAGE_OFFSET 相当于将整个kernel虚拟地址空间又分成两个部分,PAGE_OFFSET 之上是线性映射区域,之下是各种 MODULES, VMALLOC, FIXMAP 之类的映射区域。
  • 兔子

    嗨;DTB header中的memreserve域,这个属性包含的内存空间(比如:/memreserve/ 0x87800000 0x500000; ) 内核是不会对这段内存访问的吗??完全可以留着自己使用的吗?? 如果是,那么访问该内存的话是以虚拟地址方式还是物理地址方式访问呢???谢谢
    • huozi

      @兔子:既然是reserve,那就应该可用可不用。开启了MMU之后,若要用,应该要建立映射通过虚拟地址来访问。
  • HW.Yang

    Hello, >在体系结构相关的汇编初始化阶段,我们会准备二段地址的页表 請問系統如何決定這兩個頁表要被放在物理記憶體的哪個位址呢? 謝謝!
    • huozi

      @HW.Yang:页表自身存放在哪里,原文中也有一些提示,如下: 内核起始刚开始的汇编代码基本上是PIC的,首先需要定位到页表的位置,然后在页表中填入kernel image mapping和identity mapping的页表项。页表的起始位置比较好定(bss段之后),但是具体的size还是需要思考一下的。
  • Zaiqiang

    @linuxer "(PAGE_OFFSET,PAGE_OFFSET+SWAPPER_INIT_MAP_SIZE)这段虚拟内存创建地址映射,mapping到(PHYS_OFFSET,PHYS_OFFSET+SWAPPER_INIT_MAP_SIZE)这段物理内存的时候,调用create_mapping不会发生内存分配,因为所有的页表都已经存在了" 请教一下,这里PTE的页表肯定是没有的啊,肯定要分配啊,难道内核是使用的是块映射吗?如果还是,我理解肯定需要分配一页做PTE啊。
    • 啊啊啊 主页

      @Zaiqiang:之前使用的是section映射,现在要pte映射,所以需要内存
    • jqdeng

      @Zaiqiang:用的已经不是启动时的页表,而是在early_fixmap_init里面使用了bm_pud/bm_pmd/bm_pte这三个数组重新建立了映射
  • orangeboyye

    《内存初始化(下)》,在哪里可以看到,急切盼望
  • 鱼儿

    在建立kernle image的映射时,为什么要使用section map有点疑问, 假设48 bit的虚拟地址配置,4k的page size,这时候需要4级映射,地址被分成9(level 0 or PGD) + 9(level 1 or PUD) + 9(level 2 or PMD) + 9(level 3 or PTE) + 12(page offset),假设我们分配4个page分别保存Level 0到level 3的translation table,那么可以建立的最大的地址映射范围是512(level 3中有512个entry) X 4k = 2M。 对于这段话不理解的是,为何只算level3呢?level0 和level1为何只放一个entry?
    • melo

      @鱼儿:我觉得: 假设我们分配4个page分别保存 只有4个pages, 第一个page存放pgd, 第二个放pud, 第三个放pmd, 第四个放pte pte最多放512个entries 为何只算level3呢?如果低于level3, 需要的pages就多于4个了
      • landau

        @melo:基于melo 的说法,如果level0不止一个entry,那么意味着level1的entry不止一个page(此时一个page在level0~level3 中都是能保存512个entry),因为level0的entry存放的值,对应的是pgd table中的level1的table的地址。level1也同理。所以在只有4个page的场景下,那么level0-level2 有且只能各有一个page,同时里面只能有一个entry。 此时最大的地址映射范围,自然也是有level3 里面entry的个数决定。
        • huozi

          @landau:我想原文应该也是想表达这样一个意思,举一个映射范围最大为2M的例子,只是他这个例子,我们读者可能都默认level0-level2对应的三个page均填满,那样映射范围肯定不止2M,原文level0-level2 均是只有一个entry才有原文的结论。
  • 啊啊啊 主页

    因为前三级都是0->1->2,只有最后那个4k指向具体的页,懂了吧,前三个只是页表系统的一部分,你不能用0级页表指向具体内存吧,
    • huozi

      @啊啊啊:你这个前提就是entry0、entry1、entry2均是1,entry3为512才是这个,但为什么level 0、level 1、level 2、level 3均有1page保存,为什么entry0、entry1、entry2均是1,entry3为512呢?
  • korone

    补充对PIC术语的说明: PIC,即 Position Independent Code ,地址无关代码。这种代码可以在主存储器中任意位置正确地运行。
  • huozi

    我也是还没看懂这句话,映射范围不应该是entry0*entry1*entry2*entry3*4k吗? 另外entry3为何是512?