蜗窝科技

linux kernel的中断子系统之(八):softirq

linuxer · · 中断子系统 · 阅读 126682 · 2014年10月存档

一、前言

对于中断处理而言,linux将其分成了两个部分,一个叫做中断handler(top half),是全程关闭中断的,另外一部分是deferable task(bottom half),属于不那么紧急需要处理的事情。在执行bottom half的时候,是开中断的。有多种bottom half的机制,例如:softirq、tasklet、workqueue或是直接创建一个kernel thread来执行bottom half(这在旧的kernel驱动中常见,现在,一个理智的driver厂商是不会这么做的)。本文主要讨论softirq机制。由于tasklet是基于softirq的,因此本文也会提及tasklet,但主要是从需求层面考虑,不会涉及其具体的代码实现。

在普通的驱动中一般是不会用到softirq,但是由于驱动经常使用的tasklet是基于softirq的,因此,了解softirq机制有助于撰写更优雅的driver。softirq不能动态分配,都是静态定义的。内核已经定义了若干种softirq number,例如网络数据的收发、block设备的数据访问(数据量大,通信带宽高),timer的deferable task(时间方面要求高)。本文的第二章讨论了softirq和tasklet这两种机制有何不同,分别适用于什么样的场景。第三章描述了一些context的概念,这是要理解后续内容的基础。第四章是进入softirq的实现,对比hard irq来解析soft irq的注册、触发,调度的过程。

注:本文中的linux kernel的版本是3.14

二、为何有softirq和tasklet

1、为何有top half和bottom half

中断处理模块是任何OS中最重要的一个模块,对系统的性能会有直接的影响。想像一下:如果在通过U盘进行大量数据拷贝的时候,你按下一个key,需要半秒的时间才显示出来,这个场景是否让你崩溃?因此,对于那些复杂的、需要大量数据处理的硬件中断,我们不能让handler中处理完一切再恢复现场(handler是全程关闭中断的),而是仅仅在handler中处理一部分,具体包括:

(1)有实时性要求的

(2)和硬件相关的。例如ack中断,read HW FIFO to ram等

(3)如果是共享中断,那么获取硬件中断状态以便判断是否是本中断发生

除此之外,其他的内容都是放到bottom half中处理。在把中断处理过程划分成top half和bottom half之后,关中断的top half被瘦身,可以非常快速的执行完毕,大大减少了系统关中断的时间,提高了系统的性能。

我们可以基于下面的系统进一步的进行讨论:

rrr

当网卡控制器的FIFO收到的来自以太网的数据的时候(例如半满的时候,可以软件设定),可以将该事件通过irq signal送达Interrupt Controller。Interrupt Controller可以把中断分发给系统中的Processor A or B。

NIC的中断处理过程大概包括:mask and ack interrupt controller——–>ack NIC——–>copy FIFO to ram——>handle Data in the ram———–>unmask interrupt controller

我们先假设Processor A处理了这个网卡中断事件,于是NIC的中断handler在Processor A上欢快的执行,这时候,Processor A的本地中断是disable的。NIC的中断handler在执行的过程中,网络数据仍然源源不断的到来,但是,如果NIC的中断handler不操作NIC的寄存器来ack这个中断的话,NIC是不会触发下一次中断的。还好,我们的NIC interrupt handler总是在最开始就会ack,因此,这不会导致性能问题。ack之后,NIC已经具体再次trigger中断的能力。当Processor A上的handler 在处理接收来自网络的数据的时候,NIC的FIFO很可能又收到新的数据,并trigger了中断,这时候,Interrupt controller还没有umask,因此,即便还有Processor B(也就是说有处理器资源),中断控制器也无法把这个中断送达处理器系统。因此,只能眼睁睁的看着NIC FIFO填满数据,数据溢出,或者向对端发出拥塞信号,无论如何,整体的系统性能是受到严重的影响。

注意:对于新的interrupt controller,可能没有mask和umask操作,但是原理是一样的,只不过NIC的handler执行完毕要发生EOI而已。

要解决上面的问题,最重要的是尽快的执行完中断handler,打开中断,unmask IRQ(或者发送EOI),方法就是把耗时的handle Data in the ram这个步骤踢出handler,让其在bottom half中执行。

2、为何有softirq和tasklet

OK,linux kernel已经把中断处理分成了top half和bottom half,看起来已经不错了,那为何还要提供softirq、tasklet和workqueue这些bottom half机制,linux kernel本来就够复杂了,bottom half还来添乱。实际上,在早期的linux kernel还真是只有一个bottom half机制,简称BH,简单好用,但是性能不佳。后来,linux kernel的开发者开发了task queue机制,试图来替代BH,当然,最后task queue也消失在内核代码中了。现在的linux kernel提供了三种bottom half的机制,来应对不同的需求。

workqueue和softirq、tasklet有本质的区别:workqueue运行在process context,而softirq和tasklet运行在interrupt context。因此,出现workqueue是不奇怪的,在有sleep需求的场景中,defering task必须延迟到kernel thread中执行,也就是说必须使用workqueue机制。softirq和tasklet是怎么回事呢?从本质上将,bottom half机制的设计有两方面的需求,一个是性能,一个是易用性。设计一个通用的bottom half机制来满足这两个需求非常的困难,因此,内核提供了softirq和tasklet两种机制。softirq更倾向于性能,而tasklet更倾向于易用性。

我们还是进入实际的例子吧,还是使用上一节的系统图。在引入softirq之后,网络数据的处理如下:

关中断:mask and ack interrupt controller——–>ack NIC——–>copy FIFO to ram——>raise softirq——>unmask interrupt controller

开中断:在softirq上下文中进行handle Data in the ram的动作

同样的,我们先假设Processor A处理了这个网卡中断事件,很快的完成了基本的HW操作后,raise softirq。在返回中断现场前,会检查softirq的触发情况,因此,后续网络数据处理的softirq在processor A上执行。在执行过程中,NIC硬件再次触发中断,Interrupt controller将该中断分发给processor B,执行动作和Processor A是类似的,因此,最后,网络数据处理的softirq在processor B上执行。

为了性能,同一类型的softirq有可能在不同的CPU上并发执行,这给使用者带来了极大的痛苦,因为驱动工程师在撰写softirq的回调函数的时候要考虑重入,考虑并发,要引入同步机制。但是,为了性能,我们必须如此。

当网络数据处理的softirq同时在Processor A和B上运行的时候,网卡中断又来了(可能是10G的网卡吧)。这时候,中断分发给processor A,这时候,processor A上的handler仍然会raise softirq,但是并不会调度该softirq。也就是说,softirq在一个CPU上是串行执行的。这种情况下,系统性能瓶颈是CPU资源,需要增加更多的CPU来解决该问题。

如果是tasklet的情况会如何呢?为何tasklet性能不如softirq呢?如果一个tasklet在processor A上被调度执行,那么它永远也不会同时在processor B上执行,也就是说,tasklet是串行执行的(注:不同的tasklet还是会并发的),不需要考虑重入的问题。我们还是用网卡这个例子吧(注意:这个例子仅仅是用来对比,实际上,网络数据是使用softirq机制的),同样是上面的系统结构图。假设使用tasklet,网络数据的处理如下:

关中断:mask and ack interrupt controller——–>ack NIC——–>copy FIFO to ram——>schedule tasklet——>unmask interrupt controller

开中断:在softirq上下文中(一般使用TASKLET_SOFTIRQ这个softirq)进行handle Data in the ram的动作

同样的,我们先假设Processor A处理了这个网卡中断事件,很快的完成了基本的HW操作后,schedule tasklet(同时也就raise TASKLET_SOFTIRQ softirq)。在返回中断现场前,会检查softirq的触发情况,因此,在TASKLET_SOFTIRQ softirq的handler中,获取tasklet相关信息并在processor A上执行该tasklet的handler。在执行过程中,NIC硬件再次触发中断,Interrupt controller将该中断分发给processor B,执行动作和Processor A是类似的,虽然TASKLET_SOFTIRQ softirq在processor B上可以执行,但是,在检查tasklet的状态的时候,如果发现该tasklet在其他processor上已经正在运行,那么该tasklet不会被处理,一直等到在processor A上的tasklet处理完,在processor B上的这个tasklet才能被执行。这样的串行化操作虽然对驱动工程师是一个福利,但是对性能而言是极大的损伤。

三、理解softirq需要的基础知识(各种context)

1、preempt_count

为了更好的理解下面的内容,我们需要先看看一些基础知识:一个task的thread info数据结构定义如下(只保留和本场景相关的内容):

struct thread_info {
……
int preempt_count; /* 0 => preemptable, <0 => bug */
……
};

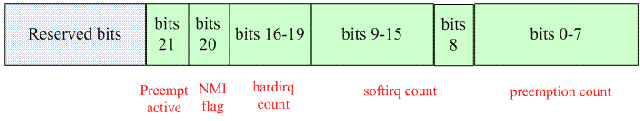
preempt_count这个成员被用来判断当前进程是否可以被抢占。如果preempt_count不等于0(可能是代码调用preempt_disable显式的禁止了抢占,也可能是处于中断上下文等),说明当前不能进行抢占,如果preempt_count等于0,说明已经具备了抢占的条件(当然具体是否要抢占当前进程还是要看看thread info中的flag成员是否设定了_TIF_NEED_RESCHED这个标记,可能是当前的进程的时间片用完了,也可能是由于中断唤醒了优先级更高的进程)。 具体preempt_count的数据格式可以参考下图:
preempt-count

preemption count用来记录当前被显式的禁止抢占的次数,也就是说,每调用一次preempt_disable,preemption count就会加一,调用preempt_enable,该区域的数值会减去一。preempt_disable和preempt_enable必须成对出现,可以嵌套,最大嵌套的深度是255。

hardirq count描述当前中断handler嵌套的深度。对于ARM平台的linux kernel,其中断部分的代码如下:

void handle_IRQ(unsigned int irq, struct pt_regs *regs)
{
struct pt_regs *old_regs = set_irq_regs(regs);

irq_enter();
generic_handle_irq(irq);

irq_exit();
set_irq_regs(old_regs);
}

通用的IRQ handler被irq_enter和irq_exit这两个函数包围。irq_enter说明进入到IRQ context,而irq_exit则说明退出IRQ context。在irq_enter函数中会调用preempt_count_add(HARDIRQ_OFFSET),为hardirq count的bit field增加1。在irq_exit函数中,会调用preempt_count_sub(HARDIRQ_OFFSET),为hardirq count的bit field减去1。hardirq count占用了4个bit,说明硬件中断handler最大可以嵌套15层。在旧的内核中,hardirq count占用了12个bit,支持4096个嵌套。当然,在旧的kernel中还区分fast interrupt handler和slow interrupt handler,中断handler最大可以嵌套的次数理论上等于系统IRQ的个数。在实际中,这个数目不可能那么大(内核栈就受不了),因此,即使系统支持了非常大的中断个数,也不可能各个中断依次嵌套,达到理论的上限。基于这样的考虑,后来内核减少了hardirq count占用bit数目,改成了10个bit(在general arch的代码中修改为10,实际上,各个arch可以redefine自己的hardirq count的bit数)。但是,当内核大佬们决定废弃slow interrupt handler的时候,实际上,中断的嵌套已经不会发生了。因此,理论上,hardirq count要么是0,要么是1。不过呢,不能总拿理论说事,实际上,万一有写奇葩或者老古董driver在handler中打开中断,那么这时候中断嵌套还是会发生的,但是,应该不会太多(一个系统中怎么可能有那么多奇葩呢?呵呵),因此,目前hardirq count占用了4个bit,应付15个奇葩driver是妥妥的。

对softirq count进行操作有两个场景:

(1)也是在进入soft irq handler之前给 softirq count加一,退出soft irq handler之后给 softirq count减去一。由于soft irq handler在一个CPU上是不会并发的,总是串行执行,因此,这个场景下只需要一个bit就够了,也就是上图中的bit 8。通过该bit可以知道当前task是否在sofirq context。

(2)由于内核同步的需求,进程上下文需要禁止softirq。这时候,kernel提供了local_bh_enable和local_bh_disable这样的接口函数。这部分的概念是和preempt disable/enable类似的,占用了bit9~15,最大可以支持127次嵌套。

2、一个task的各种上下文

看完了preempt_count之后,我们来介绍各种context:

#define in_irq() (hardirq_count())
#define in_softirq() (softirq_count())
#define in_interrupt() (irq_count())

#define in_serving_softirq() (softirq_count() & SOFTIRQ_OFFSET)

这里首先要介绍的是一个叫做IRQ context的术语。这里的IRQ context其实就是hard irq context,也就是说明当前正在执行中断handler(top half),只要preempt_count中的hardirq count大于0(=1是没有中断嵌套,如果大于1,说明有中断嵌套),那么就是IRQ context。

softirq context并没有那么的直接,一般人会认为当sofirq handler正在执行的时候就是softirq context。这样说当然没有错,sofirq handler正在执行的时候,会增加softirq count,当然是softirq context。不过,在其他context的情况下,例如进程上下文中,有有可能因为同步的要求而调用local_bh_disable,这时候,通过local_bh_disable/enable保护起来的代码也是执行在softirq context中。当然,这时候其实并没有正在执行softirq handler。如果你确实想知道当前是否正在执行softirq handler,in_serving_softirq可以完成这个使命,这是通过操作preempt_count的bit 8来完成的。

所谓中断上下文,就是IRQ context + softirq context+NMI context。

四、softirq机制

softirq和hardirq(就是硬件中断啦)是对应的,因此softirq的机制可以参考hardirq对应理解,当然softirq是纯软件的,不需要硬件参与。

1、softirq number

和IRQ number一样,对于软中断,linux kernel也是用一个softirq number唯一标识一个softirq,具体定义如下:

enum
{
HI_SOFTIRQ=0,
TIMER_SOFTIRQ,
NET_TX_SOFTIRQ,
NET_RX_SOFTIRQ,
BLOCK_SOFTIRQ,
BLOCK_IOPOLL_SOFTIRQ,
TASKLET_SOFTIRQ,
SCHED_SOFTIRQ,
HRTIMER_SOFTIRQ,
RCU_SOFTIRQ, /* Preferable RCU should always be the last softirq */

NR_SOFTIRQS
};

HI_SOFTIRQ用于高优先级的tasklet,TASKLET_SOFTIRQ用于普通的tasklet。TIMER_SOFTIRQ是for software timer的(所谓software timer就是说该timer是基于系统tick的)。NET_TX_SOFTIRQ和NET_RX_SOFTIRQ是用于网卡数据收发的。BLOCK_SOFTIRQ和BLOCK_IOPOLL_SOFTIRQ是用于block device的。SCHED_SOFTIRQ用于多CPU之间的负载均衡的。HRTIMER_SOFTIRQ用于高精度timer的。RCU_SOFTIRQ是处理RCU的。这些具体使用情景分析会在各自的子系统中分析,本文只是描述softirq的工作原理。

2、softirq描述符

我们前面已经说了,softirq是静态定义的,也就是说系统中有一个定义softirq描述符的数组,而softirq number就是这个数组的index。这个概念和早期的静态分配的中断描述符概念是类似的。具体定义如下:

struct softirq_action
{
void (*action)(struct softirq_action *);
};

static struct softirq_action softirq_vec[NR_SOFTIRQS] __cacheline_aligned_in_smp;

系统支持多少个软中断,静态定义的数组就会有多少个entry。____cacheline_aligned保证了在SMP的情况下,softirq_vec是对齐到cache line的。softirq描述符非常简单,只有一个action成员,表示如果触发了该softirq,那么应该调用action回调函数来处理这个soft irq。对于硬件中断而言,其mask、ack等都是和硬件寄存器相关并封装在irq chip函数中,对于softirq,没有硬件寄存器,只有“软件寄存器”,定义如下:

typedef struct {
unsigned int __softirq_pending;
#ifdef CONFIG_SMP
unsigned int ipi_irqs[NR_IPI];
#endif
} ____cacheline_aligned irq_cpustat_t;

irq_cpustat_t irq_stat[NR_CPUS] ____cacheline_aligned;

ipi_irqs这个成员用于处理器之间的中断,我们留到下一个专题来描述。__softirq_pending就是这个“软件寄存器”。softirq采用谁触发,谁负责处理的。例如:当一个驱动的硬件中断被分发给了指定的CPU,并且在该中断handler中触发了一个softirq,那么该CPU负责调用该softirq number对应的action callback来处理该软中断。因此,这个“软件寄存器”应该是每个CPU拥有一个(专业术语叫做banked register)。为了性能,irq_stat中的每一个entry被定义对齐到cache line。

3、如何注册一个softirq

通过调用open_softirq接口函数可以注册softirq的action callback函数,具体如下:

void open_softirq(int nr, void (*action)(struct softirq_action *))
{
softirq_vec[nr].action = action;
}

softirq_vec是一个多CPU之间共享的数据,不过,由于所有的注册都是在系统初始化的时候完成的,那时候,系统是串行执行的。此外,softirq是静态定义的,每个entry(或者说每个softirq number)都是固定分配的,因此,不需要保护。

4、如何触发softirq?

在linux kernel中,可以调用raise_softirq这个接口函数来触发本地CPU上的softirq,具体如下:

void raise_softirq(unsigned int nr)
{
unsigned long flags;

local_irq_save(flags);
raise_softirq_irqoff(nr);
local_irq_restore(flags);
}

虽然大部分的使用场景都是在中断handler中(也就是说关闭本地CPU中断)来执行softirq的触发动作,但是,这不是全部,在其他的上下文中也可以调用raise_softirq。因此,触发softirq的接口函数有两个版本,一个是raise_softirq,有关中断的保护,另外一个是raise_softirq_irqoff,调用者已经关闭了中断,不需要关中断来保护“soft irq status register”。

所谓trigger softirq,就是在__softirq_pending(也就是上面说的soft irq status register)的某个bit置一。从上面的定义可知,__softirq_pending是per cpu的,因此不需要考虑多个CPU的并发,只要disable本地中断,就可以确保对,__softirq_pending操作的原子性。

具体raise_softirq_irqoff的代码如下:

inline void raise_softirq_irqoff(unsigned int nr)
{
__raise_softirq_irqoff(nr); ----------------(1)

if (!in_interrupt())
wakeup_softirqd();------------------(2)
}

(1)__raise_softirq_irqoff函数设定本CPU上的__softirq_pending的某个bit等于1,具体的bit是由soft irq number(nr参数)指定的。

(2)如果在中断上下文,我们只要set __softirq_pending的某个bit就OK了,在中断返回的时候自然会进行软中断的处理。但是,如果在context上下文调用这个函数的时候,我们必须要调用wakeup_softirqd函数用来唤醒本CPU上的softirqd这个内核线程。具体softirqd的内容请参考下一个章节。

5、disable/enable softirq

在linux kernel中,可以使用local_irq_disable和local_irq_enable来disable和enable本CPU中断。和硬件中断一样,软中断也可以disable,接口函数是local_bh_disable和local_bh_enable。虽然和想像的local_softirq_enable/disable有些出入,不过bh这个名字更准确反应了该接口函数的意涵,因为local_bh_disable/enable函数就是用来disable/enable bottom half的,这里就包括softirq和tasklet。

先看disable吧,毕竟禁止bottom half比较简单:

static inline void local_bh_disable(void)
{
__local_bh_disable_ip(_THIS_IP_, SOFTIRQ_DISABLE_OFFSET);
}

static __always_inline void __local_bh_disable_ip(unsigned long ip, unsigned int cnt)
{
preempt_count_add(cnt);
barrier();
}

看起来disable bottom half比较简单,就是讲current thread info上的preempt_count成员中的softirq count的bit field9~15加上一就OK了。barrier是优化屏障(Optimization barrier),会在内核同步系列文章中描述。

enable函数比较复杂,如下:

static inline void local_bh_enable(void)
{
__local_bh_enable_ip(_THIS_IP_, SOFTIRQ_DISABLE_OFFSET);
}

void __local_bh_enable_ip(unsigned long ip, unsigned int cnt)
{
WARN_ON_ONCE(in_irq() || irqs_disabled());-----------(1)

preempt_count_sub(cnt - 1); ------------------(2)

if (unlikely(!in_interrupt() && local_softirq_pending())) { -------(3)
do_softirq();
}

preempt_count_dec(); ---------------------(4)
preempt_check_resched();
}

(1)disable/enable bottom half是一种内核同步机制。在硬件中断的handler(top half)中,不应该调用disable/enable bottom half函数来保护共享数据,因为bottom half其实是不可能抢占top half的。同样的,soft irq也不会抢占另外一个soft irq的执行,也就是说,一旦一个softirq handler被调度执行(无论在哪一个processor上),那么,本地的softirq handler都无法抢占其运行,要等到当前的softirq handler运行完毕后,才能执行下一个soft irq handler。注意:上面我们说的是本地,是local,softirq handler是可以在多个CPU上同时运行的,但是,linux kernel中没有disable all softirq的接口函数(就好像没有disable all CPU interrupt的接口一样,注意体会local_bh_enable/disable中的local的含义)。

说了这么多,一言以蔽之,local_bh_enable/disable是给进程上下文使用的,用于防止softirq handler抢占local_bh_enable/disable之间的临界区的。

irqs_disabled接口函数可以获知当前本地CPU中断是否是disable的,如果返回1,那么当前是disable 本地CPU的中断的。如果irqs_disabled返回1,有可能是下面这样的代码造成的:

local_irq_disable();

……
local_bh_disable();

……

local_bh_enable();
……
local_irq_enable();

本质上,关本地中断是一种比关本地bottom half更强劲的锁,关本地中断实际上是禁止了top half和bottom half抢占当前进程上下文的运行。也许你会说:这也没有什么,就是有些浪费,至少代码逻辑没有问题。但事情没有这么简单,在local_bh_enable—>do_softirq—>__do_softirq中,有一条无条件打开当前中断的操作,也就是说,原本想通过local_irq_disable/local_irq_enable保护的临界区被破坏了,其他的中断handler可以插入执行,从而无法保证local_irq_disable/local_irq_enable保护的临界区的原子性,从而破坏了代码逻辑。

in_irq()这个函数如果不等于0的话,说明local_bh_enable被irq_enter和irq_exit包围,也就是说在中断handler中调用了local_bh_enable/disable。这道理是和上面类似的,这里就不再详细描述了。

(2)在local_bh_disable中我们为preempt_count增加了SOFTIRQ_DISABLE_OFFSET,在local_bh_enable函数中应该减掉同样的数值。这一步,我们首先减去了(SOFTIRQ_DISABLE_OFFSET-1),为何不一次性的减去SOFTIRQ_DISABLE_OFFSET呢?考虑下面运行在进程上下文的代码场景:

……

local_bh_disable

……需要被保护的临界区……

local_bh_enable

……

在临界区内,有进程context 和softirq共享的数据,因此,在进程上下文中使用local_bh_enable/disable进行保护。假设在临界区代码执行的时候,发生了中断,由于代码并没有阻止top half的抢占,因此中断handler会抢占当前正在执行的thread。在中断handler中,我们raise了softirq,在返回中断现场的时候,由于disable了bottom half,因此虽然触发了softirq,但是不会调度执行。因此,代码返回临界区继续执行,直到local_bh_enable。一旦enable了bottom half,那么之前raise的softirq就需要调度执行了,因此,这也是为什么在local_bh_enable会调用do_softirq函数。

调用do_softirq函数来处理pending的softirq的时候,当前的task是不能被抢占的,因为一旦被抢占,下一次该task被调度运行的时候很可能在其他的CPU上去了(还记得吗?softirq的pending 寄存器是per cpu的)。因此,我们不能一次性的全部减掉,那样的话有可能preempt_count等于0,那样就允许抢占了。因此,这里减去了(SOFTIRQ_DISABLE_OFFSET-1),既保证了softirq count的bit field9~15被减去了1,又保持了preempt disable的状态。

(3)如果当前不是interrupt context的话,并且有pending的softirq,那么调用do_softirq函数来处理软中断。

(4)该来的总会来,在step 2中我们少减了1,这里补上,其实也就是preempt count-1。

(5)在softirq handler中很可能wakeup了高优先级的任务,这里最好要检查一下,看看是否需要进行调度,确保高优先级的任务得以调度执行。

5、如何处理一个被触发的soft irq

我们说softirq是一种defering task的机制,也就是说top half没有做的事情,需要延迟到bottom half中来执行。那么具体延迟到什么时候呢?这是本节需要讲述的内容,也就是说soft irq是如何调度执行的。

在上一节已经描述一个softirq被调度执行的场景,本节主要关注在中断返回现场时候调度softirq的场景。我们来看中断退出的代码,具体如下:

void irq_exit(void)
{
……
if (!in_interrupt() && local_softirq_pending())
invoke_softirq();

……
}

代码中“!in_interrupt()”这个条件可以确保下面的场景不会触发sotfirq的调度:

(1)中断handler是嵌套的。也就是说本次irq_exit是退出到上一个中断handler。当然,在新的内核中,这种情况一般不会发生,因为中断handler都是关中断执行的。

(2)本次中断是中断了softirq handler的执行。也就是说本次irq_exit是不是退出到进程上下文,而是退出到上一个softirq context。这一点也保证了在一个CPU上的softirq是串行执行的(注意:多个CPU上还是有可能并发的)

我们继续看invoke_softirq的代码:

static inline void invoke_softirq(void)
{
if (!force_irqthreads) {
#ifdef CONFIG_HAVE_IRQ_EXIT_ON_IRQ_STACK
__do_softirq();
#else
do_softirq_own_stack();
#endif
} else {
wakeup_softirqd();
}
}

force_irqthreads是和强制线程化相关的,主要用于interrupt handler的调试(一般而言,在线程环境下比在中断上下文中更容易收集调试数据)。如果系统选择了对所有的interrupt handler进行线程化处理,那么softirq也没有理由在中断上下文中处理(中断handler都在线程中执行了,softirq怎么可能在中断上下文中执行)。本身invoke_softirq这个函数是在中断上下文中被调用的,如果强制线程化,那么系统中所有的软中断都在sofirq的daemon进程中被调度执行。

如果没有强制线程化,softirq的处理也分成两种情况,主要是和softirq执行的时候使用的stack相关。如果arch支持单独的IRQ STACK,这时候,由于要退出中断,因此irq stack已经接近全空了(不考虑中断栈嵌套的情况,因此新内核下,中断不会嵌套),因此直接调用__do_softirq()处理软中断就OK了,否则就调用do_softirq_own_stack函数在softirq自己的stack上执行。当然对ARM而言,softirq的处理就是在当前的内核栈上执行的,因此do_softirq_own_stack的调用就是调用__do_softirq(),代码如下(删除了部分无关代码):

asmlinkage void __do_softirq(void)
{

……

pending = local_softirq_pending();---------------获取softirq pending的状态

__local_bh_disable_ip(_RET_IP_, SOFTIRQ_OFFSET);---标识下面的代码是正在处理softirq

cpu = smp_processor_id();
restart:
set_softirq_pending(0); ---------清除pending标志

local_irq_enable(); ------打开中断,softirq handler是开中断执行的

h = softirq_vec; -------获取软中断描述符指针

while ((softirq_bit = ffs(pending))) {-------寻找pending中第一个被设定为1的bit
unsigned int vec_nr;
int prev_count;

h += softirq_bit - 1; ------指向pending的那个软中断描述符

vec_nr = h - softirq_vec;----获取soft irq number

h->action(h);---------指向softirq handler

h++;
pending »= softirq_bit;
}

local_irq_disable(); -------关闭本地中断

pending = local_softirq_pending();----------(注1)
if (pending) {
if (time_before(jiffies, end) && !need_resched() &&
–max_restart)
goto restart;

wakeup_softirqd();
}

__local_bh_enable(SOFTIRQ_OFFSET);----------标识softirq处理完毕

}

(注1)再次检查softirq pending,有可能上面的softirq handler在执行过程中,发生了中断,又raise了softirq。如果的确如此,那么我们需要跳转到restart那里重新处理soft irq。当然,也不能总是在这里不断的loop,因此linux kernel设定了下面的条件:

(1)softirq的处理时间没有超过2个ms

(2)上次的softirq中没有设定TIF_NEED_RESCHED,也就是说没有有高优先级任务需要调度

(3)loop的次数小于 10次

因此,只有同时满足上面三个条件,程序才会跳转到restart那里重新处理soft irq。否则wakeup_softirqd就OK了。这样的设计也是一个平衡的方案。一方面照顾了调度延迟:本来,发生一个中断,系统期望在限定的时间内调度某个进程来处理这个中断,如果softirq handler不断触发,其实linux kernel是无法保证调度延迟时间的。另外一方面,也照顾了硬件的thoughput:已经预留了一定的时间来处理softirq。

原创文章,转发请注明出处。蜗窝科技

/irq_subsystem/soft-irq.html

标签:软中断softirq

继续讨论

新讨论请用 GitHub 账号在下方发言——评论会保存在本仓库的 Discussions 里,与站点同寿; 再下方的「历史评论」是原站的只读存档。

评论(137 条,只读存档)

以下为原站的历史评论(只读存档);继续讨论请用上方的评论区。

  • forion

    又一部扛鼎之作,待老衲细细品味!
    • linuxer

      @forion:不敢当,forion同学抬爱了~~~
  • forion

    hi linuxer 有一处没看懂的地方: (4)该来的总会来,在step 2中我们少减了1,这里补上,其实也就是enable preempt。 preempt_count_dec(); ---------------------(4) 这条指令之后,并不一定使能了preempt吧?这个只是preempt count -1; preempt count=0 才是使能了preempt吧?
    • linuxer

      @forion:你说的是对的,enable preempt应该是下面一系列动作: (1)preempt count - 1 (2)test preempt count, if 0 and really need reschedule, then trigger scheduler to preempt current process. preempt_count_dec仅仅是减去1而已
    • linuxer

      @forion:forion同学,绝对是金牌读者啊
      • forion

        @linuxer:不敢当,不敢当。 这么好的文章不好好读简直就是暴殄天物啊! 楼主要坚持啊。
        • linuxer

          @forion:如果我现在的公司不倒闭的话,我应该会坚持下去的(现在我所在的公司没有那么忙,呵呵~~)。不过如果公司倒了,我要去找新的工作,那就不好说了。其实,在中国,技术大牛很多,只不过他们都没有什么时间在互联网上分享而已。
          • forion

            @linuxer:是啊,所以找到一个好老师不容易啊。
  • linuxer

    修改了强制线程化的内容,原来的理解有偏差
  • azureming

    Linuxer,你好,又来请教个问题; 既然可以采用threaded_irq,那么所谓的bottom机制【比如softirq】是不是可以不使用了,或者他们在使用的时候各有应用场景来着? 谢谢
    • linuxer

      @azureming:中断线程化是从linux的rt tree导入的一个特性,因此,threaded irq更多的是从系统实时性的角度来看待问题。 如果把threaded irq handler和bottom half对比的话,可能workqueue(而不是softirq)更合适一些,毕竟work是在进程上下文中执行的,和threaded irq handler是类似的。不过虽然都是在进程上下文执行,但是,还是有不一样的,对于线程化的irq handler,其执行在一个实时进程上,也就是说本质上原来在handler在中断上下文中执行,但是现在修改为在系统中的一个rt进程中执行,所有threaded irq handler都是先于系统中的normal进程被调度执行。 对于workqueue,其进程是一个普通进程,需要和很多系统中的普通的进程共同争抢cpu资源。 我们来看一个场景:如果某个外设是慢速总线设备,例如I2C(呵呵,I2C总是在各种场合下出现),读取I2C上的数据不适合在interrupt handler中执行,因此,我们考虑使用workqueue。但是,如果I2C外设的FIFO很小,而系统又很繁忙,那么这种场景下使用workqueue就会丢失来自外设的数据。这时候,使用threaded irq handler会改善。当然,是否保证不丢失数据是一个系统问题,你需要仔细的设计系统中所有task的优先级 soft irq是一定需要的,它是在中断上下文执行的,只要是中断上下文,其优先级总是高过进程上下文
      • tigger

        @linuxer:这里可能还要补充一下linux调度策略以及调度器类的概念。但是我的功力还不够正确的描述出来。所以可以通俗的理解rt进程会优先于normal进程被调度执行就可以了。其实我的理解是rt进程对应的调度器类的优先级高于完全公平进程。不知道这样表述是否可以。
        • linuxer

          @tigger:那些内容是任务管理子系统的内容,这里我就偷懒一下吧,等到release任务管理子系统的文档再详细讲述调度器以及调度算法的内容吧
      • azureming

        @linuxer:我可不可以这样理解: workqueue这个下半部和普通进程的优先级一样,所以有时候这个下半部得不到及时的执行; threaded irq优先级高于普通进程,这点和soft irq一样(高的优先级),可以让待处理的任务得到较早的执行,相对于soft irq不能被进程抢占,threaded irq的机制则可以通过设置某些进程更高的优先级,从而获得比threaded irq更早的执行机会,从而满足特定的实时性要求。 soft irq的存在主要是为了保证这个下半部的优先执行权限,不能被进程打断?
        • linuxer

          @azureming:你的理解基本上是正确的,linux kernel提供了各种工具,如何正确的使用这些工具,适合自己的系统也是一个很有技术含量的工作,也就是传说中的系统设计过程。
      • schedule

        @linuxer:soft irq是一定需要的,它是在中断上下文执行的,只要是中断上下文,其优先级总是高过进程上下文 ====================================================================== 假设,只是假设,中断长时间不来咋办?
        • linuxer

          @schedule:本来的场景不就是产生了中断,将不急迫处理的内容放到bottom half(例如softirq)中,因此,如果中断长时间不来,那么软中断也没有执行的必要啊。我是不是没有搞清楚你的问题?
  • ayeu0425

    写得好,一下子就全懂了
  • super-

    @linuxer: 1. thread irq handler 和 中断底半部机制是共存的吗? 2. 如果是共存的, 那么如果我在thread irq handler中使用workqueue底半部机制, 那么这个顶半部运行在哪个进程中? 底半部运行在哪个进程中?
    • super-

      @super-:希望能为我解除疑惑
    • super-

      @super-:希望能为我解除疑惑
    • linuxer

      @super-:中断处理分成top half和bottom half,top half在中断上下文,如果使用softirq或者tasklet这样的机制,其执行也在中断上下文,因此不能sleep,如果确有需求,那么可以采用workqueue,因为workqueue在进程上下文。 如果你想要使用中断线程化的处理机制,那么top half就是irq handler,在中断上下文。bottom half都移到thread irq handler中执行,属于进程上下文 1. thread irq handler 和 中断底半部机制是共存的吗? ---------------------------- 可以是共存的 2. 如果是共存的, 那么如果我在thread irq handler中使用workqueue底半部机制, 那么这个顶半部运行在哪个进程中? 底半部运行在哪个进程中? ---------------------------- 你这样的使用实在是太诡异了,根本没有必要在thread irq handler中使用workqueue的机制,thread irq handler已经是进程上下文了,何必要使用workqueue?如果一定要这么用,那么上下文环境是这样的:top half用于不会运行于某个进程,alway是属于interrupt context,thread irq handler是运行在该irq的那个内核线程中,而在thread irq handler中queue的work运行在workqueue的进程上下文中
      • super-

        @linuxer:handle_level_irq handle_irq_event handle_irq_event_percpu action->handler{return IRQ_WAKE_THREAD} irq_wake_thread 谢谢您的回复,看了下代码弄懂了。
  • Daniel Shieh

    in_interrupt()就是判断是否在中断上下文,是吧?在do_softirq函数中总会有下面这句 if (in_interrupt()) return; 那这样的话,会不会马上返回? 软中断或者tasklet的执行过程中应该一直满足这个情况,那还能继续向下执行吗?就直接返回了吧?具体的中断上下文理解应该如何理解呢?定义到底是什么呢?望大牛讲解下,谢谢。
    • 蜗蜗

      @Daniel Shieh:linuxer同学最近有点忙,我先试着理解一下吧,看看能不能帮到你。 本文一开篇就讲到,中断处理分为top half和bottom half。 top half是全程关中断的,因而是本质上的中断上下文,in_interrupt()判断的就是这种情况。 bottom half是开中断的,是由特殊的线程处理的,其本质上是进程上下文,也就不是中断上下文了。softirq正是实现bottom half的一中方式,因而,理所当然的,do_softirq不能在中断上下文调用。
      • linuxer

        @蜗蜗:最近是有点忙,你先顶着,我也快要解脱啦,唉,套用我经常说的一句话:这奏是人生啊
      • jinxinxin163

        @蜗蜗:还是想请教下,既然invoke_softirq 和 do_softirq本质上都是在进程上下文运行,那是怎么保证比一般内核线程/进程更好的实时性和维持这么重要的角色的呢
        • linuxer

          @jinxinxin163:invoke_softirq 是在中断上下文执行。 do_softirq一般来说会在进程上下文执行。 invoke_softirq 的执行过程是irq_exit----->invoke_softirq,也就是说,在top half退出的时候,如果有pending的softirq,就会调用该函数,因此invoke_softirq一般是中断上下文运行。 do_softirq的执行过程是local_bh_enable---->__local_bh_enable_ip---->do_softirq,一般用在进程上下文通过local_bh_disable和local_bh_enable保护临界区的时候使用。在临界区内产生了中断,raise了softirq,但是返回临界区的时候,不能执行softirq handler(因为disable了bottom half),因此,在立刻临界区的时候,要立刻启动那个pending softirq的处理。 最后一句话总结:bottom half可以抢占进程上下文的执行,除非进程上下文显示的禁止了bottom half。
      • jey

        @蜗蜗:@蜗蜗:你上面说: top half是全程关中断的,因而是本质上的中断上下文,in_interrupt()判断的就是这种情况。 bottom half是开中断的,是由特殊的线程处理的,其本质上是进程上下文,也就不是中断上下文了。 ------------------------------------------------------------ 由上面你的回复我的理解是:是中断上下文还是进程上下文是通过有没有关闭中断来决定的 我的理解正确吗?
        • wowo

          @jey:不正确。是否在中断上下文,本质上取决于CPU的处理器模式。 另外,可以轻易的举出反例:进程上下文,一样可以关中断啊。
        • linuxer

          @jey:关于中断上下文和进程上下文,我的理解是这样的: 1、对于内核态的程序,是否运行在进程上下文还是中断上下文,主要看当时current指向的task是否和当前执行的代码是否有直接的关系。 2、如果用户进程通过系统调用进入内核,那么这时候毫无疑问是进程上下文,因为当前的内核代码执行路径就是代替用户空间进程在内核态运行,这时候随意的阻塞当前进程是OK的,不会有任何的歧义。 3、如果中断打断了某个进程的执行,从而转入interrupt handler执行,这时候,current task和当前内核执行路径没有一毛钱的关系,current是无辜的,是躺枪的,异步的中断事件毫无预警的击中了current进程,从而陷入内核,这时候内核路径是不能block当前进程的,在这种情况下,内核代码执行在中断上下文。 4、无论是top half还是bottom half,其本质都是中断上下文,都不能阻塞当前进程。当然,有一种特例:那就是在softirqd中执行的软中断handler,这时候的上下文实际上是进程上下文。
          • jey

            @linuxer:谢谢两位大神的耐心回答
    • linuxer

      @Daniel Shieh:in_interrupt()就是判断是否在中断上下文,是吧? --------------------------------------------------- 很遗憾,不是。实际上,中断上下文包括两种情况: 1、执行该中断的处理函数(或者叫做top half) 2、执行软中断处理函数,执行tasklet函数,执行timer callback函数。(或者统称bottom half) 对于上面的第二种情况,稍微有些复杂,其执行的现场包括: 1、执行完top half,立刻启动bottom half的执行 2、在softirqd这个内核线程中执行 对于上面的情况1,毫无疑问,绝对的中断上下文,对于情况2,虽然是在内核线程中执行,但是我也倾向将其归入中断上下文。 OK,上面就是我理解的中断上下文的含义,下面我们来看代码。 in_irq()是用来判断是否在中断上下文top half的。我们一起来来看看in_irq()是如何定义的: #define in_irq() (hardirq_count()) #define hardirq_count() (preempt_count() & HARDIRQ_MASK) 也就是说,in_irq就是检查hardirq counter那4个bit的值。在中断处理过程中,irq_enter说明进入到IRQ context,而irq_exit则说明退出IRQ context。在irq_enter函数中会调用preempt_count_add(HARDIRQ_OFFSET),为hardirq count的bit field增加1。在irq_exit函数中,会调用preempt_count_sub(HARDIRQ_OFFSET),为hardirq count的bit field减去1。因此,只要in_irq非零,则说明在中断上下文并且处于top half部分。 in_serving_softirq()是用来判断是否在中断上下文bottom half的(也可能是在softirqd中哦) 我们一起来来看看in_interrupt是如何定义的: #define in_interrupt() (irq_count()) #define irq_count() (preempt_count() & (HARDIRQ_MASK | SOFTIRQ_MASK \ | NMI_MASK)) HARDIRQ_MASK和NMI_MASK都没有问题,在中断上下文,但是SOFTIRQ_MASK还是有些问题的, SOFTIRQ_MASK这8个bit分成两个部分: 1、也是在进入soft irq handler之前给 softirq count加一,退出soft irq handler之后给 softirq count减去一。由于soft irq handler在一个CPU上是不会并发的,总是串行执行,因此,这个场景下只需要一个bit就够了,也就是preempt_count的bit 8。通过该bit可以知道当前task是否在sofirq context。 2、由于内核同步的需求,进程上下文需要禁止softirq。这时候,kernel提供了local_bf_enable和local_bf_disable这样的接口函数。这部分的概念是和preempt disable/enable类似的,占用了bit9~15,最大可以支持127次嵌套。 因此,in_interrupt()除了包括了中断上下文的场景,还包括了进程上下文禁止softirq的场景。
      • Daniel Shieh

        @linuxer:醍醐灌顶,谢谢大牛啊
  • Daniel Shieh

    楼主研究过netlink吗?在硬件中断中,执行netlink的发送会产生内核的一个warning,但是可以继续执行,而且只是在中断中第一次执行netlink的发送netlink_unicast函数时,通过dmesg能看到一次内核warning,接下来的所有中断都不会再产生这个内核warning,而且所有的中断处理过程都是ok的,只是这个内核warning应该怎么处理呢?是不是必须要处理掉? 内核产生的warning信息如下: We have entered irq handle programme! GNS_ICR is 0x1 netlink:send message '76005010'. ------------[ cut here ]------------ WARNING: at kernel/softirq.c:159 local_bh_enable+0x7d/0xb0() (Not tainted) Hardware name: Modules linked in: gns_pcie_ep(U) vfat fat usb_storage fuse autofs4 8021q garp stp llc cpufreq_ondemand acpi_cpufreq freq_table mperf ipt_REJECT nf_conntrack_ipv4 nf_defrag_ipv4 iptable_filter ip_tables ip6t_REJECT nf_conntrack_ipv6 nf_defrag_ipv6 xt_state nf_conntrack ip6table_filter ip6_tables ipv6 uinput iTCO_wdt iTCO_vendor_support microcode i2c_i801 sg e1000e ptp pps_core shpchp lpc_ich mfd_core ext4 jbd2 mbcache sd_mod crc_t10dif pata_acpi ata_generic ata_piix xhci_hcd i915 drm_kms_helper drm i2c_algo_bit i2c_core video output dm_mirror dm_region_hash dm_log dm_mod [last unloaded: scsi_wait_scan] Pid: 0, comm: swapper Not tainted 2.6.32-431.el6.x86_64 #1 Call Trace: <IRQ> [<ffffffff81071e27>] ? warn_slowpath_common+0x87/0xc0 [<ffffffff81071e7a>] ? warn_slowpath_null+0x1a/0x20 [<ffffffff8107b5bd>] ? local_bh_enable+0x7d/0xb0 [<ffffffff8146f59d>] ? sk_filter+0x9d/0xd0 [<ffffffff814866e5>] ? netlink_unicast+0x195/0x320 [<ffffffffa03cabb1>] ? sendnlmsg+0x131/0x160 [gns_pcie_ep] [<ffffffff810ec944>] ? __rcu_process_callbacks+0x54/0x350 [<ffffffffa03cac4f>] ? gns_pci_irq+0x6f/0x280 [gns_pcie_ep] [<ffffffff810e6ec0>] ? handle_IRQ_event+0x60/0x170 [<ffffffff810a266d>] ? sched_clock_cpu+0xcd/0x110 [<ffffffff810e981e>] ? handle_edge_irq+0xde/0x180 [<ffffffff8100faf9>] ? handle_irq+0x49/0xa0 [<ffffffff81530fdc>] ? do_IRQ+0x6c/0xf0 [<ffffffff8100b9d3>] ? ret_from_intr+0x0/0x11 <EOI> [<ffffffff812e09be>] ? intel_idle+0xde/0x170 [<ffffffff812e09a1>] ? intel_idle+0xc1/0x170 [<ffffffff814266f7>] ? cpuidle_idle_call+0xa7/0x140 [<ffffffff81009fc6>] ? cpu_idle+0xb6/0x110 [<ffffffff8150cbea>] ? rest_init+0x7a/0x80 [<ffffffff81c26f8f>] ? start_kernel+0x424/0x430 [<ffffffff81c2633a>] ? x86_64_start_reservations+0x125/0x129 [<ffffffff81c26453>] ? x86_64_start_kernel+0x115/0x124 ---[ end trace 907b965b69105137 ]--- data0 01 is 0x4291 data0 02 is 0x2 data0 03 is 0x12345678 data0 04 is 0xedcba987 data0 05 is 0x0 data0 06 is 0x0 data0 07 is 0x0 We have entered irq handle programme! GNS_ICR is 0x2 netlink:send message '1ffb6210'. data0 11 is 0x4291 data0 12 is 0x2 data0 13 is 0x12345678 data0 14 is 0xedcba987 data0 15 is 0x0 data0 16 is 0x0 data0 17 is 0x0
    • Daniel Shieh

      @Daniel Shieh:从log信息看到,只有在第一次中断中内核打印了warning信息,接下来我只贴了两三个中断中的数据打印,不过我触发过上百次,3ms每次的频率,连续回环触发中断,都没有再出现warning,数据也没什么问题。不知道这是什么原因造成的内核warning?是和软中断的开启关闭有关系吗?我总感觉问题在这里,但是又无从下手。运行环境是X86平台,centos6.5,内核版本是2.6.32.望大牛hint me。
      • 蜗蜗

        @Daniel Shieh:warning的原因可以从本文“5、disable/enable softirq ”中找到,简单的说,就是因为在中断上下文中调用local_bh_enable了。至于为什么是一次,因为是这样调用的: WARN_ON_ONCE(in_irq() || irqs_disabled()); 至于是否需要解决这个问题,我的看法是这样的: netlink的本质,是借助socket传递数据,属于大数据传输的范畴(虽然,我猜测,您这里可能传递的数据量不大)。 因此,在中断中使用netlink传输数据,本身应该不是一种规范的做法。 再看netlink_unicast的实现,它调用了local_bh_enable,其实就已经假设或者暗示了,netlink操作,要放到bottom half中完成。 所以,您可以考虑一下,使用bottom half来完成netlink传输。
        • Daniel Shieh

          @蜗蜗:首先,数据量的确不大,但是需要在中断和用户态程序传输数据,了解下来,只有netlink是最好的方式,所以采用了netlink。 我的确也已经做了tasklet和work queue的中断下半部处理netlink发送数据,但是这两种方法都会直接把系统给卡死,然后系统自动重启。目前还不清楚哪里出了问题。但是在中断里直接发送数据,不采用下半部,系统不会卡死,只是会报上面那个warning。下半部导致系统卡死可能会有上面原因呢?丢给下半部的处理函数和中断中直接处理的函数时一样的。难道中断下半部中必须单独加自旋锁?
      • linuxer

        @Daniel Shieh:蜗蜗同学已经讲明了原因,我这里补充一下:in_irq()是用来判断是否在top half中的,本质上local_bh_disable/local_bh_enable是用来保护临界区的,但是,其实在硬件中断的handler(top half)中,不应该调用disable/enable bottom half函数来保护共享数据,因为bottom half其实是不可能抢占top half的。至于为什么是一次?我的理解是这样的,在top half中调用disable/enable bottom half函数来保护共享数据属于没有必要的操作(但是无害,浪费一点点cpu而已),因此只是给出一次警告就OK了,要是每次都告警,那么有用的log信息会被冲刷掉。
        • Daniel Shieh

          @linuxer:原来是这样的啊,这个报警信息内核觉得不是什么重大事故,所以警告一次就行了,是吧。谢谢大牛回复,瞬间感觉清晰了点,尤其是对中断这部分,这几天好好研究研究你们的这个系列。你们应该赶紧出书啊,你们写的东西比那些经典书看着都要爽很多。
          • linuxer

            @Daniel Shieh:不敢当,不敢当,虽有动笔写书的想法,不过现在时机还不成熟,我们自己还没有达到融会贯通的程度。套用我之前回复Daniel网友的话:写书是这样的过程,你自己首先是一个装满水的水库,但是准备了一桶水,给读者倒了一杯。但现在,我们只是建好了水库,还在蓄水阶段...
            • passerby

              @linuxer:博主现在写的东西比很多嵌入式方面书里面写的更好了,等以后博主将写的东西系统整理下,我觉得肯定是一本很好的书。
      • 宽

        @Daniel Shieh:这个问题,可以尝试使用broadcast试下?
  • madang

    对于中断处理而言,linux将其分成了两个部分,一个叫做中断handler(top half),是全程关闭中断的,另外一部分是deferable task(bottom half),属于不那么紧急需要处理的事情。 //---------------------------- 请教一下,这里“全程关闭中断”在哪里操作的,我怎么么没有找到对应代码
    • linuxer

      @madang:top half的“全程关闭中断”是由硬件完成的,当中断产生后,硬件会自动disable本cpu的中断处理,在进入中断handler之前,只要不显式的打开本cpu的中断,那么中断就是关闭的。 对于旧的内核,区分fast handler和slow handler,slow handler的top half在执行前,代码会打开中断的,新的内核已经是不区分fast handler和slow handler,都是fast handler,全部是关闭中断的。
      • passerby

        @linuxer:上面的do_softirq会调用local_irq_enable在软中断中支持硬件中断抢占,而在最后有local_irq_disable。这个时候中断被禁止了,在上面时候中断又被恢复?是在中断汇编返回的地方还是硬件自己做?
        • linuxer

          @passerby:我还没有搞明白你说的问题,do_softirq不会调用local_irq_enable啊,你说的是__do_softirq吗?
          • passerby

            @linuxer:是我自己想差了,我应该是问题,在top half里面调用gic的eio表示中断处理完后,这个时候GIC就会打开中断了吧?
            • linuxer

              @passerby:推荐你看看gic那篇文档,有很多硬件相关的描述。
      • madang

        @linuxer:了解。那么哪里打开中断呢?发送eoi的时候 还是退出中断处理的时候?
        • linuxer

          @madang:在执行bootom half(softirq and tasklet)之前会打开中断。如果没有pending的softirq,那么在返回中断现场的时候打开中断。
          • madang

            @linuxer:多谢。多问一句,是由硬件完成的,还是软件代码完成的? 如果是软件代码完成的,能否帮忙指点一下代码在哪里?
            • linuxer

              @madang:在__do_softirq中,如下: asmlinkage __visible void __do_softirq(void) { ...... local_irq_enable(); 处理softirq的代码 local_irq_disable(); ...... }
              • madang

                @linuxer:不好意思,可能我没有说清楚,我说的不是softirq,就是普通的中断。 中断发生以后,硬件关闭本地cpu中断,中断结束,本地中断打开。我想问的是,最后这个中断打开是谁操作的?
              • linuxer

                中断处理完毕后,并不是单纯的打开中断,而是恢复到发生中断指令的当时的现场,是软件做的。可以参考restore_user_regs(中断发生在userspace)或者svc_exit(中断发生在kernelspace)
  • madang

    假设在临界区代码执行的时候,发生了中断,由于代码并没有阻止top half的抢占,因此中断handler会抢占当前正在执行的thread。在中断handler中,我们raise了softirq, //---------------------------------------------- 这里你说的raise softirq是指中断注册的时候注册的handler吗? 还是irq_exit时候? 如果是后者的话,应该不会触发softirq的。
  • Awei

    难道不是笔误了? local_irq_disable(); -------打开中断
    • linuxer

      @Awei:应该是笔误。disable当然是关闭中断了,多谢指正!
  • madang

    问一下,IPI中断里面的 IPI_IRQ_WORK是做什么用的? 貌似和两个percpu的 list 有关, 一个lazy_list,一个是raised_list
    • linuxer

      @madang:这个和irq work机制相关。这个机制其实就是注册一个callback 函数,然后在hardirq context中执行。程序可以调用irq_work_queue或者irq_work_queue_on来注册callback函数,注册之后,当然要raise它,这是通过触发一次IPI来完成的。IPI_IRQ_WORK就是启这个作用的。 lazy_list和raised_list都是一个per cpu的链表头,注册irq work其实就是将一个struct irq_work的实例挂入队列。根据irq work的特点,可以分成两种,一种是要求立刻执行的(立刻触发IPI),另外一种是没有什么要求的,可以在tick到来的时候调用callback函数。不同的irq work会挂入不同的链表。
      • madang

        @linuxer:主要是什么应用场景啊?
        • madang

          @madang:或者说这种机制有什么作用?
          • madang

            @madang:和IPI_CALL_FUNC这个中断好像很类似啊
        • linuxer

          @madang:一般而言,我们都是期望hardirq context做的事情越少越好,尽可能的把要处理的内容推导bottom half,因此,这也就注定irq work机制不会被普通的driver使用,除非你是使用优先级更高的中断(例如:X86中的NMI或者ARM中的FIQ)。这时候,在这个更高优先级的handler中不能做太多的事情,可以考虑使用irq work机制,调用irq_work_queue,将任务delay到hardirq context中。 使用比hardirq更高优先级的应用场景多半是 watchdog、trace、debug什么的。例如CPU可能包括PMU(Performance Monitor Unit)这样的硬件单元,如果该硬件单元也使用普通的irq,那么在kernel代码disable irq的时候,PMU不就没有办法工作了吗?因此PMU可以考虑是那种代码不可以屏蔽的中断来驱动工作的。
          • madang

            @linuxer:这时候,在这个更高优先级的handler中不能做太多的事情,可以考虑使用irq work机制,调用irq_work_queue,将任务delay到hardirq context中。 //--------------------------------------- 这里没有看明白。 这里的“更高优先级的handler”应该指的的是 中断的handler吧,按照我的理解应该是在硬中断上下文执行的。 但是你有说“将任务delay到hardirq context中”, 如果这里 hardirq context也是硬中断上下文的话, 那岂不是有问题
            • linuxer

              @madang:我的意思是从NMI context推迟到hardirq context
              • madang

                @linuxer:对于arm这种没有NMI中断的系统,更高优先级的中断应该就是FIQ了吧。 一般FIQ也都是当做安全中断使用,kernel无法处理的。 这个时候,像pmu这种机制使用什么中断来实现呢 ?
              • linuxer

                @linuxer:ARM的处理器可以包括安全扩展(TrustZone),也可以不包括,对于没有包括TrustZone的,linux kernel可以之间控制FIQ,对于包括TrustZone的ARM处理器,FIQ由secure monitor控制,如果内核想要使用FIQ,那么就需要有一定的方法让secure monitor将FIQ事件传递给kernel(当然,具体什么方法我也没有深入了解)。
  • huad_

    大神,请教个问题:如果当前状态是,打开中断,关闭抢占。那么,在这个情况下,当前CPU上会有进程调度吗?
    • 郭健

      @huad_:我的理解:都已经disable了preempt,当然不会有调度了。虽然中断可以禁止抢占代码的执行,并且也许唤醒了优先级更高的进程,但是由于是禁止抢占的,因此中断返回的时候并不会发生调度。
      • huad_

        @郭健:@郭健:谢谢你的回复!如果我主动调用schedule(),这个时候也不会有进程切换吗?
        • linuxer

          @huad_:OK,看起来你的调用序列如下: ...... preempt_disable(); ...... schedule ...... preempt_enable(); ...... 其实你可以试一试的,最后你会看到这样的错误信息: BUG: scheduling while atomic:.......
          • huad_

            @linuxer:谢谢~ 试验了一下,确实会提示如上BUG,并会打印堆栈错误消息。不过系统也没有挂掉。
  • descent

    請問 softirq 可以指定執行在某個 cpu core 嗎?
    • 郭健

      @descent:应该不可以的,在哪一个CPU上raise了softirq,就在哪一个CPU上执行
      • 冬瓜哥

        @郭健:可以的。可以用ipi将软中断向其他cpu派发执行。
        • linuxer

          @冬瓜哥:能不能再说的详细一些?如何用ipi将软中断向其他CPU派发?大概的代码在哪里?
  • jinxinxin163

    Hi, wowo,有几个问题想和您讨论一下: 1. 就网卡中断的例子来讲,假如软中断执行的时候被硬件中断打断,怎么回到之前软中断执行的代码 处?软中断可不像进程那样有进程上下文! 2. 软中断打断当前进程的调用路线是怎么样的?包括打断和恢复! 3. 软中断处于中断上下文,但是却是由softirqd这个内核线程调度执行的(内核上下文),这不矛盾么? 3.有个地方写错了吧: 关本地中断实际上是禁止了top half和bottom half抢占当前进程上下文的运行 关本地中断只是禁止了top half吧 ^_^
    • wowo

      @jinxinxin163:这个让linuxer同学回答你把:-)
    • jinxinxin163

      @jinxinxin163:抱歉, 第三个问题写错了: 软中断处于中断上下文,但是却是由softirqd这个内核线程调度执行的(内核上下文),这不矛盾么? 应该是: 软中断处于中断上下文,但是却是由softirqd这个内核线程调度执行的(进程上下文),这不矛盾么?
      • linuxer

        @jinxinxin163:白天有点忙,晚上回复你,呵呵~~~
        • jinxinxin163

          @linuxer:好的好的,感谢了
  • linuxer

    1、软中断虽然是处于中断上下文,但是仍然有current process,只不过这个softirq的执行和current进程没有一毛钱的关系。被中断打断的softirq如何恢复执行?没有什么特别的啊,就是在current的内核栈上保存现场,然后恢复不就OK了吗? 2、软中断打断往往不会直接打断进程的调用线路,总是借由中断来完成,一般是中断发生,在handler中raise softirq,在irq_exit中check softirq的pending状态。 3、你再仔细看看softirqd,并不是它来调度执行softirqd的,本身softirq仍然是由hardirq raise,然后再调度的,只有在一些特殊情况下,softirqd才启动执行。 4、我的意思是如果关闭了中断,那么不会有中断handler,也就不会raise新的softirq,当然,我那么说可能是有些不严谨,我的意思是如果关闭了中断,那么不会新触发的softirq来抢占当前进程的执行。
  • jey

    读完本文之后让我想到了系统调用,我的理解是这样的,用户程序里通过写入swi指令来切换到特权模式,当CPU执行到swi指令时会从用户模式切换到管理模式下,并将PC值置成一个异常向量地址,这个地址上存放一个跳转指令,跳转到软中断处理程序,软中断处理程序根据swi指令后面的参数(系统调用号)找到对应的系统调用后开始执行系统调用。不知道我的理解对不对? 由上面我的描述我感觉系统调用中的软中断跟本文中描述的软中断区别很大啊,能否解释一下这两种软中断的区别呢?
    • linuxer

      @jey:你把swi这条“软中断指令”和中断子系统中的“软中断机制”搞混了,这两个东西是不一样的。 swi你说的已经很明白了,中断子系统中的“软中断机制”其实就是把中断处理需要执行的代码分成两个部分,一个需要尽快完成的,一个是可以推后执行的,对于那些可以推后执行的,kernel中断子系统提供了softirq的机制,让那些代码可以在中断返回user space之前执行。
      • jey

        @linuxer:我也认为他们是不一样的东西,只是想通过大牛验证一下。呵呵~ 多谢~
  • weiweishuo

    写的非常好,看的很爽快。。。。文章不罗嗦。
  • looper

    楼主,能否帮忙看看下面的问题,最近在kernel log中总会出现如下的信息: c0 BUG: sleeping function called from invalid context at /space/builder/repo/sprdroid6.0_trunk_k318_dev/kernel/mm/slub.c:1240 c0 in_atomic(): 0, irqs_disabled(): 0, pid: 1, name: init c0 Preemption disabled at:[<ffffffc0009cc934>] printk+0x7c/0x8c 根据看源代码,感觉进入sleep的dump流程是因为抢占被禁止了。还请楼主帮帮忙。
    • wowo

      @looper:应该有更多的call trace吧?打出来看看。 可能是你再atomic区域(中断、softirq等)中,调用了内存分配的函数(最终会调到slab_alloc),而内存分配可能会睡眠。
      • looper

        @wowo:回复晚了,下面是call trace [01-02 07:45:29.883] <3>[ 8.510125] c0 BUG: sleeping function called from invalid context at /space/builder/repo/sprdroid6.0_trunk_k318_dev/kernel/mm/slub.c:1240 [01-02 07:45:29.883] <3>[ 8.510150] c0 in_atomic(): 0, irqs_disabled(): 0, pid: 1, name: init [01-02 07:45:29.883] <3>[ 8.510170] c0 Preemption disabled at:[<ffffffc0009cc934>] printk+0x7c/0x8c [01-02 07:45:29.883] <4>[ 8.510218] c0 [01-02 07:45:29.883] <4>[ 8.510242] c0 CPU: 0 PID: 1 Comm: init Tainted: G W O 3.18.12+ #1 [01-02 07:45:29.883] <4>[ 8.510263] c0 Hardware name [01-02 07:45:29.884] <0>[ 8.510282] c0 Call trace: [01-02 07:45:29.884] <38>[ 8.510987] c4 logd.auditd: policy loaded [01-02 07:45:29.884] <4>[ 8.512944] c0 [<ffffffc00008b480>] dump_backtrace+0x0/0x164 [01-02 07:45:29.884] <4>[ 8.512958] c0 [<ffffffc00008b600>] show_stack+0x1c/0x28 [01-02 07:45:29.884] <4>[ 8.512972] c0 [<ffffffc0009cd570>] dump_stack+0x74/0xb8 [01-02 07:45:29.885] <4>[ 8.512988] c0 [<ffffffc0000e3414>] __might_sleep+0x198/0x1a0 [01-02 07:45:29.885] <4>[ 8.513003] c0 [<ffffffc0001e2e68>] __kmalloc_track_caller+0x220/0x2ac [01-02 07:45:29.885] <4>[ 8.513017] c0 [<ffffffc0004a8fe0>] devm_kmalloc+0x38/0x84 [01-02 07:45:29.885] <4>[ 8.513032] c0 [<ffffffc000666954>] of_devfreq_cooling_register_power+0xfc/0x314 [01-02 07:45:29.885] <4>[ 8.513060] c0 [<ffffffbffc02b27c>] kbase_devfreq_init+0x268/0x2dc [mali_kbase] [01-02 07:45:29.885] <4>[ 8.513092] c0 [<ffffffbffc018658>] kbase_release_device+0x38e0/0x3c2c [mali_kbase] [01-02 07:45:29.885] <4>[ 8.513106] c0 [<ffffffc0004a7610>] platform_drv_probe+0x50/0xcc [01-02 07:45:29.885] <4>[ 8.513120] c0 [<ffffffc0004a52c4>] driver_probe_device+0xb4/0x3c8 [01-02 07:45:29.885] <4>[ 8.513132] c0 [<ffffffc0004a56dc>] __driver_attach+0xa8/0xb0 [01-02 07:45:29.885] <4>[ 8.513145] c0 [<ffffffc0004a3150>] bus_for_each_dev+0x68/0xac [01-02 07:45:29.885] <4>[ 8.513158] c0 [<ffffffc0004a4c90>] driver_attach+0x28/0x34 [01-02 07:45:29.885] <4>[ 8.513170] c0 [<ffffffc0004a4894>] bus_add_driver+0x16c/0x248 [01-02 07:45:29.885] <4>[ 8.513183] c0 [<ffffffc0004a6074>] driver_register+0x6c/0x138 [01-02 07:45:29.885] <4>[ 8.513196] c0 [<ffffffc0004a7528>] __platform_driver_register+0x74/0x84 [01-02 07:45:29.885] <4>[ 8.513222] c0 [<ffffffbffc04b01c>] init_module+0x1c/0x28 [mali_kbase] [01-02 07:45:29.885] <4>[ 8.513235] c0 [<ffffffc000082acc>] do_one_initcall+0xcc/0x1e8 [01-02 07:45:29.885] <4>[ 8.513248] c0 [<ffffffc00013b1cc>] load_module+0x1728/0x1e08 [01-02 07:45:29.886] <4>[ 8.513259] c0 [<ffffffc00013b998>] SyS_init_module+0xec/0x148 [01-02 07:45:29.887] <6>[ 8.513381] c0 mali 60000000.gpu: Dynamic power table: 850 MHz @ 800 mV: 124 = 124 mW [01-02 07:45:29.887] <6>[ 8.513396] c0 mali 60000000.gpu: Dynamic power table: 768 MHz @ 800 mV: 112 = 112 mW 楼主,在稳定性测试中经常会发现类似问题,不知道如何解决,还请帮忙看看。谢谢。
        • wowo

          @looper:你的driver的probe函数是怎么写的?是不是有关中断、关抢占之类的? 另外可以试试在___might_sleep中加打印,查一下具体的原因。 if ((preempt_count_equals(preempt_offset) && !irqs_disabled() && !is_idle_task(current)) || system_state != SYSTEM_RUNNING || oops_in_progress) return; if (time_before(jiffies, prev_jiffy + HZ) && prev_jiffy) return; prev_jiffy = jiffies;
          • looper

            @wowo:这个问题是测试组在kernel log中发现的, 而且整个流程也是kernel 原生的代码。我用的kernel是3.18的。of_devfreq_cooling_register_power中确实有分配内存: devm_kzalloc(dev, sizeof(*dfc), GFP_KERNEL); 使用GFP_KERNEL这个标志分配内存是可以睡眠的,但是irqs_disabled(): 0, 而preempt_count_equals(preempt_offset)=0说明是有抢占或者中断被禁止了。 关键我没有头绪, 不知从何入手。 求指点。谢谢
            • wowo

              @looper:每次都有这句话吗? [01-02 07:45:29.883] <3>[ 8.510170] c0 Preemption disabled at:[<ffffffc0009cc934>] printk+0x7c/0x8c 和printk有关? mali是变成模块的? 再做rmmod、insmod测试? printk可能会输出到屏幕上?
              • looper

                @wowo:具体原因不知道。应该是Android的一种叫做Monkey测试出来的。 中间没有insomd,rmmod。 而mail是什么东西,我也不清楚。估计是上层的什么应用吧。 在稳定性测试中还有类似的情况: BUG: sleeping function called from invalid context at /space/builder/repo/sprdroid6.0mr1_prime_k318_dev/kernel/kernel/locking/mutex.c:97 in_atomic(): 0, irqs_disabled(): 128, pid: 3909, name: mali-renderer [01-01 08:56:28.356] <0>[ 2881.732806] c0 Call trace: [01-01 08:56:28.356] <4>[ 2881.735432] c0 [<ffffffc00008b480>] dump_backtrace+0x0/0x164 [01-01 08:56:28.356] <4>[ 2881.735441] c0 [<ffffffc00008b600>] show_stack+0x1c/0x28 [01-01 08:56:28.356] <4>[ 2881.735453] c0 [<ffffffc0009d121c>] dump_stack+0x74/0xb8 [01-01 08:56:28.356] <4>[ 2881.735464] c0 [<ffffffc0000e33d4>] __might_sleep+0x158/0x1a0 [01-01 08:56:28.356] <4>[ 2881.735473] c0 [<ffffffc0009d9d48>] mutex_lock+0x28/0x50 [01-01 08:56:28.356] <4>[ 2881.735483] c0 [<ffffffc000740c58>] devfreq_monitor_resume+0x20/0xb0 [01-01 08:56:28.356] <4>[ 2881.735494] c0 [<ffffffc000742548>] devfreq_simple_ondemand_handler+0x80/0xc4 [01-01 08:56:28.356] <4>[ 2881.735502] c0 [<ffffffc000740998>] devfreq_resume_device+0x34/0x5c [01-01 08:56:28.356] <4>[ 2881.735521] c0 [<ffffffbffc014df0>] kbase_release_device+0x78/0x3b90 [mali_kbase] [01-01 08:56:28.356] <4>[ 2881.735532] c0 [<ffffffc0004acdc4>] pm_generic_runtime_resume+0x38/0x58 [01-01 08:56:28.356] <4>[ 2881.735541] c0 [<ffffffc0004aec70>] __rpm_callback+0x70/0x9c [01-01 08:56:28.356] <4>[ 2881.735550] c0 [<ffffffc0004aeccc>] rpm_callback+0x30/0xa0 [01-01 08:56:28.356] <4>[ 2881.735558] c0 [<ffffffc0004afff4>] rpm_resume+0x424/0x5f0 [01-01 08:56:28.356] <4>[ 2881.735566] c0 [<ffffffc0004b0224>] __pm_runtime_resume+0x64/0xa0 [01-01 08:56:28.356] <4>[ 2881.735582] c0 [<ffffffbffc01ea20>] kbase_platform_fake_register+0x18c/0xef8 [mali_kbase] [01-01 08:56:28.356] <4>[ 2881.735597] c0 [<ffffffbffc02868c>] kbase_pm_clock_on+0x9c/0x1ac [mali_kbase] [01-01 08:56:28.356] <4>[ 2881.735612] c0 [<ffffffbffc026dd4>] kbase_pm_do_poweron+0x24/0x3c [mali_kbase] [01-01 08:56:28.356] <4>[ 2881.735627] c0 [<ffffffbffc0295f0>] kbase_pm_update_active+0xa0/0x18c [mali_kbase] [01-01 08:56:28.356] <4>[ 2881.735642] c0 [<ffffffbffc027128>] kbase_hwaccess_pm_gpu_active+0x1c/0x2c [mali_kbase] [01-01 08:56:28.376] <4>[ 2881.735656] c0 [<ffffffbffc00d860>] kbase_pm_context_active_handle_suspend+0xbc/0xc4 [mali_kbase] [01-01 08:56:28.376] <4>[ 2881.735670] c0 [<ffffffbffc00b300>] kbase_js_sched+0x148/0x86c [mali_kbase] [01-01 08:56:28.376] <4>[ 2881.735682] c0 [<ffffffbffc0074e8>] kbase_jd_submit+0x318/0x3b4 [mali_kbase] [01-01 08:56:28.376] <4>[ 2881.735696] c0 [<ffffffbffc017318>] kbase_release_device+0x25a0/0x3b90 [mali_kbase] [01-01 08:56:28.376] <4>[ 2881.735708] c0 [<ffffffc000246d20>] compat_SyS_ioctl+0xbc/0x1688 都是进入了sleep中。
  • wowo

    @looper,第二个问题就比较直接: runtime PM resume的时候(__pm_runtime_resume),会关中断(spin_lock_irqsave),但是,在resume的过程中,调到devfreq_simple_ondemand_handler-->devfreq_monitor_resume了,而在devfreq_monitor_resume中,有mutex_lock的调用。就出现上面的警告了。你查一下为什么会有这个流程。 PS:mali是ARM的GPU,看情况,问题都出在相关的代码中,你可以检查一下代码。
    • looper

      @wowo:那您的意思是: 关中断之后不应该进入mutex_lock中去? 而根据打印出来的信息: in_atomic(): 0 和irqs_disabled(): 128 irqs_disabled(): 128,说明中断是被屏蔽了。 in_atomic(): 0说明目前处于原子操作上下文中。 而进入might_sleep的条件: if ((preempt_count_equals(preempt_offset) && !irqs_disabled() && !is_idle_task(current)) || oops_in_progress) return; 说明irqs_disabled(): 128 导致的。 这个问题出现概率极高,每次测试都会出现。目前还没有解决。根据整个执行流程来看,全部是kernel原生的代码,没有自己写的代码。
      • wowo

        @looper:是的,中断都已经关闭了,mutex_lock就已经没有调用的意义了。另外,如果lock已经被其它地方获取了,这时会发生调度,由于中断被关闭了,所以是很危险的。
        • looper

          @wowo:我不是很明白为啥关掉了中断,mutex_lock就没有调用的意义了? 那该问题出现的原因是不是您说的“代码执行流程存在问题?”
  • tree

    void raise_softirq(unsigned int nr) { unsigned long flags; local_irq_save(flags); raise_softirq_irqoff(nr); local_irq_restore(flags); } linuxer问个问题,既然该函数在中断处理函数中调用,这时候中断已经关闭了,那还在关闭中断,是不是多余的操作?
    • linuxer

      @tree:如果你确定你的调用场景是关中断的,那么其实可以不使用raise_softirq而使用raise_softirq_irqoff。如果不确定,还是使用raise_softirq安全一些。
      • tree

        @linuxer:再咨询一个问题: 既然中断分为Top Half和Bottom Half, Top Half是全程关闭中断的,在Bottom Half中打开中断。根据代码是在__do_softirq函数中调用local_irq_enable打开中断的,而在处理完soft中断之后又调用local_irq_disable关闭了中断。 这样处理完整个中断后,中断还是关闭的,估计我是没找到在哪里开中断的? 还请指点,谢谢。
        • linuxer

          @tree:对于ARM处理器,中断状态保存在cpsr寄存器中。发生中断的时候,硬件上下文保存在内核栈上,当恢复现场的时候就会恢复cpsr的值,也就enable了中断。
  • lucky

    Hi linuxer, @linuxer,您好: 看了您的文章收获非常大,现有几个问题罗列出来希望指点一二,谢谢。 1. 本文中提到的这个流程图:关中断:mask and ack interrupt controller-------->ack NIC-------->copy FIFO to ram------>raise softirq------>unmask interrupt controller =>最后一步unmask interrupt controller 这个是在中断处理程序执行完由硬件操作寄存器来进行操作的吗? irq_exit rcu_irq_exit local_irq_save(flags); local_irq_restore(flags); 既然流程第一步已经进行了执行了mask,为什么rcu_irq_exit 还会进行关闭中断的操作啊?硬中断处理中关闭中断的操作是硬件实现的? 2. 关于softirq的执行场景,目前我的理解: 1)是在中断上下文: irq_exit if (!in_interrupt() && local_softirq_pending()) //有pending softirq且没有disable_bh invoke_softirq(); 2)一个使用local_bh_disable和local_bh_enable来保护临界区的task,在local_bh_enable退出临界区时如有pending softirq则在该task的进程上下文执行。 3)由wakeup_softirqd 唤醒,在softirqd的进程上下文中执行。 综上所述的情况,我们说softirq和tasklet运行在中断上下文是不是有些不恰当? 3. 关于下面这段代码有个疑问想请教一下: do_softirq(void) local_irq_save(flags); //save本地中断状态,关中断 ----- a pending = local_softirq_pending(); __do_softirq(); pending = local_softirq_pending();//获取 softirq pending 状态 ----- m set_softirq_pending(0); //清除pending标志 local_irq_enable //开中断 ----- b h->action(h); ----- c local_irq_disable //关中断 ----- d pending = local_softirq_pending();//重新获取 softirq pending 状态 ----- n if (pending) { if (time_before(jiffies, end) && !need_resched() && --max_restart) goto restart; wakeup_softirqd(); } local_irq_restore(flags); //restore本地中断状态,开中断 ----- e 在c过程中又发生了中断打断了正在执行的softirq handler,又raise了softirq,那么中断结束又返回到被打断的softirq handler,继续执行m处获取的pending softirq,执行完毕后在n处获取新的 pending softirq 跳转到restart那里重新处理,我的描述正确吗? 谢谢!
    • linuxer

      @lucky:最后一步unmask interrupt controller 这个是在中断处理程序执行完由硬件操作寄存器来进行操作的吗? ----------- 这里说的mask或者ack某个IRQ number的操作是通过操作中断控制器(例如GIC)的寄存器来完成的。 既然流程第一步已经进行了执行了mask,为什么rcu_irq_exit 还会进行关闭中断的操作啊?硬中断处理中关闭中断的操作是硬件实现的? --------------- rcu_irq_exit中的中断操作是成对的,分别是local_irq_save和local_irq_restore,都是操作的CPU中断,而mask操作是disable某个外设的IRQ,操作的是中断控制器,是不一样的。 综上所述的情况,我们说softirq和tasklet运行在中断上下文是不是有些不恰当? -------------- 这是一个见仁见智的问题,不同的人对中断上下文理解不同,我对中断上下文的理解就是当前执行那一点的current thread和当前执行路径是没有任何的关系 关于第三个问题,你的描述是正确的。
  • cade

    例如:softirq、tasklet、workqueue或是直接创建一个kernel thread来执行bottom half(这在旧的kernel驱动中常见,现在,一个理智的driver厂商是不会这么做的) ---------------------------------------------------- @linuxer,很多次提到不创建单独的thread实现bh,除了会占用pid外,还会有哪些弊端?想知道这和workqueue的优劣是什么,workqueue有更高的优先级? Thanks~
    • linuxer

      @cade:为什么linux kernel要创立workqueue这种机制?因为太多的驱动有这样的需求:有些中断处理代码需要在进程上下文中执行(例如:这些代码会导致sleep)。没有workqueue这种机制,各个驱动只能是自己创建内核线程,但是毫无疑问,这样会导致资源极大的浪费(进程id是其一,还有很多其他的资源,例如内存消耗也比较大,调度器需要调度更多的thread等),在这样的背景下才有了workqueue这种机制。因此,一般情况下,驱动应该使用workqueue机制而不是创建内核线程。 当然,本质上workqueue也是基于内核线程的,其实使用内核线程也不是不可以,不过需要考虑很多实现面的东西,例如是否在suspend过程中冻结该内核线程?该内核线程是绑定在一个CPU上还是为每一个cpu创建一个?当向该内核线程发送的请求太多的时候,是否串行化处理请求,还是创建更多的内核线程来处理?还有很多需要考量的东西。但是,很快你就会发现,其实这些在workqueue这样的机制中都已经有考量了。所以:为何要使用内核线程呢?内核已经有了一个“轮子”你为何还要重复创建“轮子”呢?
      • cade

        @linuxer:@linuxer 感谢! 其实我针对的应用场景是这样的:VR设备上传感器对latency要求尽量小(kernel-->hal : <1ms),throughput中断至少1000Hz。现在也没有找到好的测量手段,使用单独的thread总感觉比workqueue轻量,如果仅从自己模块角度而不考虑系统其他模块,单独的thread更容易控制也不会受其他模块阻塞。。。你说的哪些我还没有考虑到:-(
        • panda

          @cade:在kernel/driver需要的地方增加trace_printk,将android应用层systrace数据和kernel的trace数据输出到同一个文件,然后用chrome打开trace文件,就可以很方便的测量出latency。
  • cracker

    Hi linuxer 我有几个问题向您请教下: 1、假如我在中断ISR中调用local_bh_disable 那是否软中断callback因为不满足!in_interrupt的条件就永远不会执行?还是可以后面调用raise_softirq()通过ksoftirq去触发softirq? 2、还有啊,执行invoke_sofrirq还有个条件就是检查local_softirq_pending,本地cpu是否有待处理的softirq是在哪里设置的? 3、softirq执行时根据不同的irq number有不同的处理,是在kernel启动的过程中静态定义的callback,我现在不清楚这些callback大概做了什么事情?和我的dirver module的中断处理有什么关系??? 4、在 __local_bh_enable_ip采用SOFTIRQ_DISABLE_OFFSET-1的做法去赤星pending的softirq,是为什么啊?内核不是提供ksoftirq线程去处理了吗?如果此时有更高优先级的进程要占用cpu,该进程会被延时处理吗? 问题太多了,不好意思~
    • cracker

      @cracker:Hi linuxer 再追加问个问题, 5、我tp模块设置的中断触发为边沿触发,当我在触摸tp时,tp会不断给cpu发送中断信号,在某一时刻按下power让系统睡眠,发现设备可以正常休眠,为什么啊? 我的理解是top half阶段内核禁止抢占,如果不断的有中断产生,cpu此时不是在generic_handle_irq中循环处理中断吗?我看边沿触发是这样处理的
  • tczb

    文章写得很好,现在看起来也收获很大 @linuxer, 也麻烦请教几个问题(和中断相关),感谢: 我遇到一个kenerl panic,oops如下,有几个疑惑: 1. Call trace里面分2部分,以Exception stack为分界,上面的中断处理和下面的kthread,在内核中是2个线程分别在处理吗? 2. 中断处理do_softirq,应该是个TIMERIRQ,回调函数是blk_mq_rq_timer,这个软中断是由内核(时钟计时)自动启动线程来调用的吗?用户态不可控? 3. 如果1成立,这2个线程应该存在竞争关系?处理不当,可能会有race condition问题 Call trace: [<ffffffc000350690>] blk_mq_tag_to_rq+0x34/0xc4 [<ffffffc0003552d8>] bt_for_each+0x78/0x114 [<ffffffc0003553e8>] blk_mq_tag_busy_iter+0x74/0x84 [<ffffffc000351254>] blk_mq_rq_timer+0x68/0x138 [<ffffffc0001014e0>] call_timer_fn.isra.29+0x2c/0x9c [<ffffffc000101788>] run_timer_softirq+0x238/0x2d8 [<ffffffc0000a6ec0>] __do_softirq+0x110/0x25c [<ffffffc0000a72c8>] irq_exit+0x90/0xc0 [<ffffffc0000f17f8>] __handle_domain_irq+0x9c/0x10c [<ffffffc00008250c>] gic_handle_irq+0x50/0xb4 Exception stack(0xffffffc07b24f840 to 0xffffffc07b24f970) f840: 7c20d500 ffffffc0 00000000 00000080 7b24f9b0 ffffffc0 00350b80 ffffffc0 f860: 80000145 00000000 ffffffff 00000000 7b24fa50 ffffffc0 0000001b 00000000 f880: 00302200 00000000 00000000 00000000 7c9aa000 ffffffc0 00000038 00000000 f8a0: 00000000 01000000 00000000 00000000 5d004d80 ffffffc0 00000000 00000000 f8c0: 60db1478 ffffffc0 00000000 00000000 7d66d068 ffffffc0 60db1000 ffffffc0 f8e0: 74733b60 ffffffc0 60da5f08 ffffffc0 60d1a208 ffffffc0 38000000 0000185c f900: 001fbfdc ffffffc0 5b06a72c 00000072 3f800000 00000000 7c20d500 ffffffc0 f920: 00000011 00000000 7ffe2e00 ffffffc0 7dbff880 ffffffc0 7c9b1000 ffffffc0 f940: 7b24fae0 ffffffc0 5d004cc0 ffffffc0 0091b000 ffffffc0 00000009 00000000 f960: 7d642200 ffffffc0 7b24f9b0 ffffffc0 [<ffffffc000085f80>] el1_irq+0x80/0xf4 [<ffffffc000352ac4>] blk_mq_map_request+0xbc/0x1d4 [<ffffffc000353fc8>] blk_sq_make_request+0x80/0x29c [<ffffffc000344608>] generic_make_request+0xd8/0x154 [<ffffffc000344728>] submit_bio+0xa4/0x1c0 [<ffffffc0001e9108>] _submit_bh+0x158/0x240 [<ffffffc0001e9214>] submit_bh+0x24/0x2c [<ffffffc00029cbe4>] jbd2_journal_commit_transaction+0x9ac/0x1998 [<ffffffc0002a246c>] kjournald2+0xd8/0x2ac [<ffffffc0000c5d4c>] kthread+0xe8/0x104 Code: f9403000 f8765813 f9401a74 f9401e77 (f9406a95) ---[ end trace 75da3e8cdd880aeb ]--- Kernel panic - not syncing: Fatal exception in interrupt
    • linuxer

      @tczb:你的场景我猜是这样的:文件系统的日志线程愉快的运行,但是被一次timer的中断无情的插入了,因为blk的一个timer到期了,因此转到那个timer的handler中执行,在这个timer handler执行过程中,出现了严重的问题,导致kernel panic了。 你的场景包括一个内核线程和timer的中断上下文(hw irq和soft irq context),没有两个线程,当然,如果你认为中断上下文也是一种“线程”,那么就两个线程好了,哈哈,不过在linux的世界不是这么玩的。中断上下文是非常轻的,其实不算是线程。
      • tczb

        @linuxer:谢谢linuxer回复;再麻烦下,还有个疑问,求详细解答下 1. 那个timer中断是怎么发起的呢?由谁 什么时候触发的,和上面的日志线程有关吗 不知道是不是这样:按文章的介绍,应该是硬件发起一个hard irq(这里可能是磁盘驱动),然后raise timer softirq? timer超时是内核不断去检查么? 2. 明白,但如果中断上下文有访问共享资源,也是要类似线程,加锁吧? ------- 不过在linux的世界不是这么玩的。中断上下文是非常轻的,其实不算是线程。 -------
  • 小学生

    楼主,请问为什么softirq在同一个CPU上要串行化处理呢?为什么不可以像中断那样:低优先级的softirq可以被高优先级的softirq抢占并先执行呢?是防止功能错误还是性能考虑呢?
    • linuxer

      @小学生:在讨论你的问题之前,我们先考虑这样的一个问题:A interrupt handler可以抢占B interrupt handler的执行吗? 在2.6.35的内核之前,一个interrupt handler可以是开中断的(slow handler),或者是关中断的(fast handler),只有slow handler才会被其他的打断执行,从而引入nested interrupt handler的概念。 其实在新的内核中,中断已经是不能被抢占的了,所有的interrupt handler都是fast handler,也就是说,即便是一个新的,优先级更高的中断到来,其实cpu并不会响应,要等到当前的中断handler执行完毕才会考虑响应下一个中断,所有的interrupt handler都是关中断执行的。 在新的内核中,实际上是简化了interrupt handler处理,nested interrupt handler有很多坏处: 1、中断栈的溢出问题不好处理 2、中断延迟不确定,影响realtime 3、不断的中断当前CPU处理,cache性能不佳 4、内核控制路径的同步处理变得复杂 ...... softirq的情况其实有点类似hardirq,你可以考虑一下。任何需要softirq抢占的场景都可以用其他方法实现。
  • busdriver

    调用do_softirq函数来处理pending的softirq的时候,当前的task是不能被抢占的,因为一旦被抢占,下一次该task被调度运行的时候很可能在其他的CPU上去了(还记得吗?softirq的pending 寄存器是per cpu的)。因此,我们不能一次性的全部减掉,那样的话有可能preempt_count等于0,那样就允许抢占了。因此,这里减去了(SOFTIRQ_DISABLE_OFFSET-1),既保证了softirq count的bit field9~15被减去了1,又保持了preempt disable的状态。 ______________________________ 这段话没看懂。do_softirq处理的是本地cpu pending的softirq,看后面讲述的do_softirq的流程,如果softirq超过2ms或者有更高优先级的任务就绪或者pending的softirq超过10次,都会激活线程softirqd,而这时候又是禁止抢占的,那么softirq将得不到执行而返回当前task吗?假如不禁止抢占,softirqd也将在本地cpu执行,返回也将在本地,当前task有可能被调度到别的cpu吗?这点不明白,谢谢解惑。
    • linuxer

      @busdriver:这里表面上看起来是进程抢占进程,实际上进程抢占softirq。softirq被进程抢占本身就是不合理的,在Linux的内核中,只有softirq抢占进程,没有进程抢占softirq。 如果禁止抢占,那么一定会回到原来的那一点,等打开抢占的时候,调度器会决定是否执行softirqd。 如果softirqd抢占了当前task,那么当前task被挂入了本cpu的run queue,在负载均衡的时候,该task还是有可能调度到其他cpu上去的。
      • busdriver

        @linuxer:@linuxer 非常感谢!这回懂了。
        • kuninchengdu

          @busdriver:一般而且,do_softirp都是raiseirqoff后,软中断执行的,为啥一直在强调taskset呢,如果不是taskset,就算do_softirq被硬中断抢占,硬中断执行完后,还是原来的cpu继续执行do_softirq吧? 或者说,你的task就是指进程,进程又怎么执行soft_irq呢
  • linuxer_fy 主页

    "NIC的中断处理过程大概包括:mask and ack interrupt controller-------->ack NIC-------->copy FIFO to ram------>handle Data in the ram----------->unmask interrupt controller" ######### 由这个想到的,LINUX中针对PIC是8259A的,在do_IRQ中,先mask_and_ack_8259a,然后handle_IRQ_event,最后enable_8259a_irq(即unmask), 如此一来,岂不是针对某IRQ,不可能会产生中断嵌套,即在handle_IRQ_event中,即使打开了CPU本地的中断,但8259A芯片侧依然mask该IRQ 因此,LINUX中将同一IRQ上产生的嵌套中断序列化这一做法在这里不起作用了
    • linuxer

      @linuxer_fy:在旧的内核中允许中断嵌套,但是嵌套永远都是发生在不同的irq之间,同一种irq,无论过去还是现在都不会嵌套。
      • linuxer_fy

        @linuxer:旧内核只是允许进入当前这个中断Handler时,可以通过SA_INTERRRUPT开启中断,这样别的IRQ的中断可以响应。同IRQ都不能嵌套的话,那处理同一个IRQ的handler时,__do_IRQ,当初为什么设计成串行化呢,出于什么目的? 并且对于global的interrupt,同一个IRQ被Mask掉后,SMP中所有CPU也都无法产生这个IRQ的中断了,也就是说不管是单CPU还是多CPU,好像都没必要将一个IRQ的handler串行化设计阿。
        • linuxer

          @linuxer_fy:A IRQ可以中断A IRQ handler的执行,你觉得意义何在呢?
          • linuxer_fy

            @linuxer:我只是在这里针对LINUX的中断设计提出疑问。 另外你上面提到的 “同一种irq,无论过去还是现在都不会嵌套。” 这种情况是通过第一次进入A的handler是mask当前IRQ line来实现的吧 我又想了想,但不确定。针对SMP场合,这里的mask IRQ line是只针对当前CPU的 local APIC还是针对SMP中所有global的? 我想知道linux上实现同一个irq不会嵌套,是指当前正在处理A的CPU本地不会产生同样的中断还是说整个SMP中都不会产生,都被屏蔽掉了? 总而言这,我想搞清楚,在SMP上,一个中断A产生后,是不是在这期间这个中断不可能再出现了(包括本地CPU和其他 CPU上)
            • 玖伍贰柒

              @linuxer_fy:ARM平台上,CPU收到中断后硬件会自动将CPSR寄存器的IRQ位置1,CPU将不会再响应中断,以此保证不会嵌套。对于其它CPU的场景,则由GIC保证,GIC对每个中断维护了一个状态机,当该中断处于active状态时,GIC不会把该中断再发给其它CPU。
  • linuxer_fy 主页

    "调用do_softirq函数来处理pending的softirq的时候,当前的task是不能被抢占的,因为一旦被抢占,下一次该task被调度运行的时候很可能在其他的CPU上去了(还记得吗?softirq的pending 寄存器是per cpu的)。因此,我们不能一次性的全部减掉,那样的话有可能preempt_count等于0,那样就允许抢占了。" ############## 我对这一条有不同的看法。 do_softirq-> 判断 in_interrupt ->无条件禁止本地中断 --> __do_softirq -> __local_bh_disable -> 开本地中断 ->处理softirq handler 所以当前task不能被抢占是指不能在正在处理softirq handler中,而由于有__local_bh_disable(即bit8为1),所以当前task永远不会被抢占。所以进程上下文调用local_bh_enable时,为了兼顾(3)中将要执行的do_softirq,而只减去 (offset -1) 是不是多余了? 当前task如果在 (2)中全部减去offset,而在(3)之间被抢占的话,再次返回到当前task时, 即使是在另一个CPU上运行,也不会有影响。
    • searchthetruth

      @linuxer_fy:如果我没有记错的话在LDD3中关于tasklet的讲解中曾提到“对于tasklet来说最好保证其始终在同一个cpu上进行处理。” tasklet即是一种特殊的softirq,出于这样的角度考虑的话那么此处的(offset-1)就是一个很好方法去保证softirq始终在同一cpu上处理的方法。 为何要保证tasklet始终在同一cpu上处理的深层原因目前我也不太清楚。
      • 停停走走

        @searchthetruth:softies pending bit是per cpu的,一旦被调度到别的cpu不会再执行原来那个soft irq了吧
  • owen

    softirqd 会被进程抢占的吧。
    • chenningjun

      @owen:不会,但softirqd内部 cond_resched 主动出让CPU了。 按目前理解:调度抢占是针对用户态。内核态只有中断。
    • lx

      @owen:应该是的,大佬的中断子系统之(五)文章中写道:“在Linux kernel中,一个外设的中断处理被分成top half和bottom half,top half进行最关键,最基本的处理,而比较耗时的操作被放到bottom half(softirq、tasklet)中延迟执行。虽然bottom half被延迟执行,但始终都是先于进程执行的。为何不让这些耗时的bottom half和普通进程公平竞争呢?因此,linux kernel借鉴了RTOS的某些特性,对那些耗时的驱动interrupt handler进行线程化处理,在内核的抢占点上,让线程(无论是内核线程还是用户空间创建的线程,还是驱动的interrupt thread)在一个舞台上竞争CPU”,我的理解就是对于耗时的软中断就是可以被高优先级的进程抢占
    • deng

      @owen:ksoftirqd真正执行do_softirq的时候应该不会,抢占入口判断当前如果是中断上下文就不会执行切换
  • 农夫山泉

    关本地中断实际上是禁止了top half和bottom half抢占当前进程上下文的运行?这个是怎么实现的,看local_irq_disable()的代码并没有关软中断/
    • shousi

      @农夫山泉:我理解是进exception的时候,硬件关闭了CPU的Interrupt位。直到irq_exit里面才主动打开。可以在qmeu里打个断点看下。
    • bsp

      @农夫山泉:linux的软中断(invoke_softirq) 是在硬中段(top half)退出时才会执行,关了hardirq就等于关了softirq。
  • lingkep

    考古到了大佬的文章 看的好爽 另外有个疑问想请教下,在__irq_exit_rcu中判断if (!in_interrupt() && local_softirq_pending());invoke_softirq();之前会执行preempt_count_sub(HARDIRQ_OFFSET);那么既然中断不能嵌套,并且已经退出了硬中断上下文,这时不就是在进程上下文吗,不明白为什么您说invoke_softirq是在中断上下文执行呢
    • deng

      @lingkep:如果硬中断打断的是软中断的执行,虽然硬中断退出了,但是仍然处在软中断上下文,文章可能是想表达这个吧