蜗窝科技

linux kernel内存回收机制

itrocker · · 内存管理 · 阅读 42736 · 2015年11月存档

无论计算机上有多少内存都是不够的,因而linux kernel需要回收一些很少使用的内存页面来保证系统持续有内存使用。页面回收的方式有页回写、页交换和页丢弃三种方式:如果一个很少使用的页的后备存储器是一个块设备(例如文件映射),则可以将内存直接同步到块设备,腾出的页面可以被重用;如果页面没有后备存储器,则可以交换到特定swap分区,再次被访问时再交换回内存;如果页面的后备存储器是一个文件,但文件内容在内存不能被修改(例如可执行文件),那么在当前不需要的情况下可直接丢弃。

1 回收的时机

2 哪些内存可以回收

2.1 页框的回收

LRU(Least Recently Used),近期最少使用链表,是按照近期的使用情况排列的,最少使用的存在链表末尾,通过以下宏定义即可看出:

#define lru_to_page(_head) (list_entry((_head)->prev, struct page, lru))

每个zone有5个LRU链表用以存放各种最近使用状态的页面。

enum lru_list {

LRU_INACTIVE_ANON = LRU_BASE,

LRU_ACTIVE_ANON = LRU_BASE + LRU_ACTIVE,

LRU_INACTIVE_FILE = LRU_BASE + LRU_FILE,

LRU_ACTIVE_FILE = LRU_BASE + LRU_FILE + LRU_ACTIVE,

LRU_UNEVICTABLE,

NR_LRU_LISTS

};

其中INACTIVE_ANON、ACTIVE_ANON、INACTIVE_FILE、ACTIVE_FILE 4个链表中的页面是可以回收的。ANON代表匿名映射,没有后备存储器;FILE代表文件映射。

页面回收时,会优先回收INACTIVE的页面,只有当INACTIVE页面很少时,才会考虑回收ACTIVE页面。

为了评估页的活动程度,kernel引入了PG_referend和PG_active两个标志位。为什么需要两个位呢?假定只使用一个PG_active来标识页是否活动,在页被访问时,设置该位,但是何时清楚呢?为此需要维护大量的内核定时器,这种方法注定是要失败的。

使用两个标志,可以实现一种更精巧的方法,其核心思想是:一个表示当前活动程度,一个表示最近是否被引用过,下图说明了基本算法。
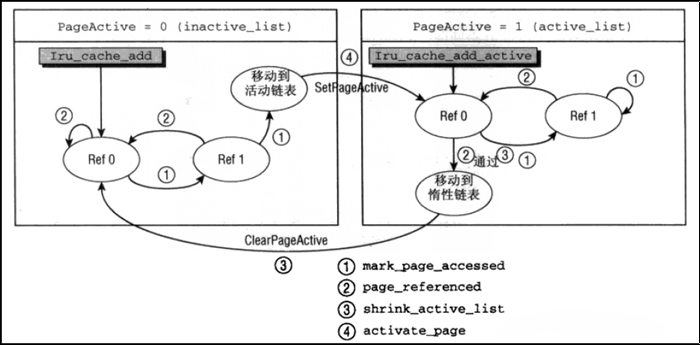
基本上有以下步骤:

(1)如果页是活动的,设置PG_active位,并保存在ACTIVE LRU链表;反之在INACTIVE;

(2)每次访问页时,设置PG_referenced位,负责该工作的是mark_page_accessed函数;

(3)PG_referenced以及由逆向映射提供的信息用来确定页面活动程度,每次清除该位时,都会检测页面活动程度,page_referenced函数实现了该行为;

(4)再次进入mark_page_accessed。如果发现PG_referenced已被置位,意味着page_referenced没有执行检查,因而对于mark_page_accessed的调用比page_referenced更频繁,这意味着页面经常被访问。如果该页位于INACTIVE链表,将其移动到ACTIVE,此外还会设置PG_active标志位,清除PG_referenced;

(5)反向的转移也是有可能的,在页面活动程度减少时,可能连续调用两次page_referenced而中间没有mark_page_accessed。

如果对内存页的访问是稳定的,那么对page_referenced和mark_page_accessed的调用在本质上是均衡的,因而页面保持在当前LRU链表。这种方案同时确保了内存页不会再ACTIVE与INACTIVE链表间快速跳跃。

2.2 slab****缓存回收

slab缓存回收相对比较灵活,所有注册到shrinker_list中的方法都会被执行。

内核默认针对每个文件系统都注册了prune_super方法,这个函数用来回收文件系统中不再使用的dentry和inode缓存;

android的lowmemorykiller机制注册了选择性杀死进程的方法,回收进程使用的内存。

3****怎样回收页框
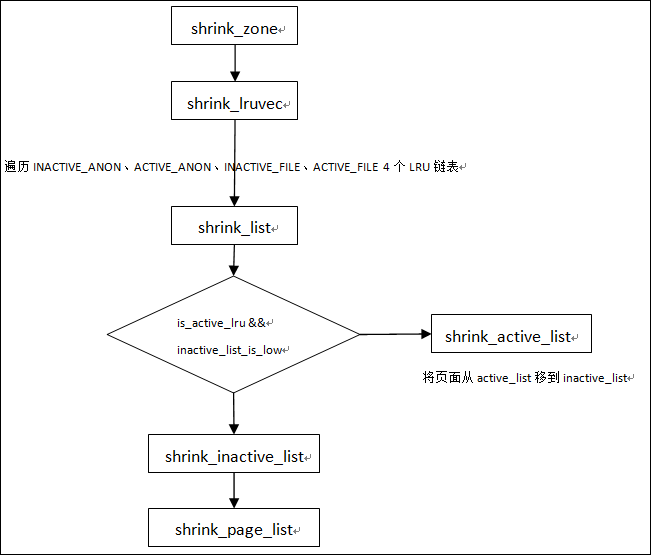
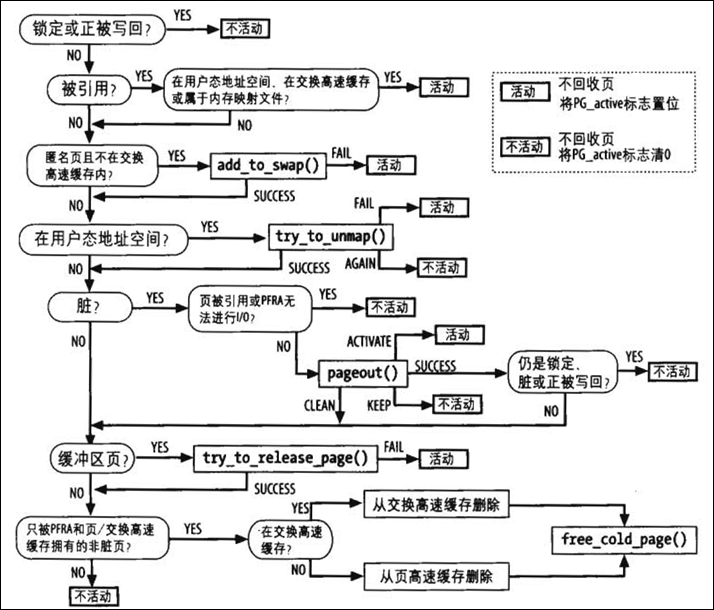
其中shrink_page_list是真正回收页面的过程
4****周期性回收的频率

4.1 kswapd

kswapd是内核为每个内存node创建的内存回收线程,为什么有了紧缺回收机制还需要周期性回收呢?因为有些内存分配是不允许阻塞等待回收的,比如中断和异常处理程序中的内存分配;还有些内存分配不允许激活I/O访问的。只有少数情况的内存紧缺可以完整执行回收过程,所以利用系统空闲时间回收内存非常必要。

该函数记录了上一次均衡操作时所用的分配order,如果kswapd_max_order大于上一次的值,或者classzone_idx小于上一次的值,则调用balance_pgdat再次均衡该内存域,否则可以进行短暂休眠,休眠的时间是HZ/10,对于arm(HZ=100)来说,休眠的时间就是1ms。

balance_pgdat均衡操作直到该内存域的zone_wartermark_ok为止。

4.2 cache_reap

cache_reap用来回收slab中的空闲对象,如果空闲对象可以还原成一个页面,则释放回buddy system。每次调用cache_reap会把所有的slab_caches遍历一遍,之后休眠2*HZ,对于arm(HZ=100)来说,周期就是20ms。

5 参考文献

(1)《understanding the linux kernel》

(2)《professional linux kernel architecture》

继续讨论

新讨论请用 GitHub 账号在下方发言——评论会保存在本仓库的 Discussions 里,与站点同寿; 再下方的「历史评论」是原站的只读存档。

评论(37 条,只读存档)

以下为原站的历史评论(只读存档);继续讨论请用上方的评论区。

  • linuxer

    itrocker,看你写了不少内存管理的文档,有没有兴趣负责内存管理子系统这个类别的文档维护?
    • itrocker

      @linuxer:有兴趣,荣幸之至:)
      • linuxer

        @itrocker:wowo同学,要不再加一个内存管理的入口?让itroker来维护如何?我感觉凭借我们两个人不可能能把内核中的所有的东西搞清楚(业余时间哪里够用啊),有必要把某些模块分出去,发动群众的力量
        • wowo

          @linuxer:没问题,交给我处理。
          • wowo

            @wowo:已经创建,并把itrocker的两篇移到这个分类下面了。 内存管理也是一个庞然大物啊,itrocker加油!
            • itrocker

              @wowo:感谢二位大神,我会努力!加油! ^_^
  • Daniel Shieh

    恭喜蜗窝科技又有一员大将加入,期待后续的文章。顺便问一下,itrocker是要写Linux内存管理这个系列的哪些内容呢?不知道是否有目录放出?嘻嘻,迫不及待啊......
    • itrocker

      @Daniel Shieh:感谢关注:) 目前还没有完整的规划,都是利用业余时间解决心中对kenrel的一些疑问,并分享给大家,共同讨论。正如wowo所说,内存管理非常庞大,千页的大部头书也讲不完,我只能以绵薄之力陆续将常用技术的点点滴滴整理一下
  • ericzhou

    你好,请教一个问题。 当回收一个页框时,怎么知道这个页框是否在被使用呢? 如果用户程序映射到这个页框,并正在使用,是不是就不能回收?
    • 郭健

      @ericzhou:你好,请教一个问题。 当回收一个页框时,怎么知道这个页框是否在被使用呢? ------------------------------------------- struct page中有reference counter,可以用来确定该page是否被引用。 如果用户程序映射到这个页框,并正在使用,是不是就不能回收? ------------------------------------------- 如果用户程序的正文段mapping到了某个物理page上来,实际上,在内存比较紧俏的时候,仍然会回收该page,只不过,但该用户程序再次执行的时候,访问正文段产生异常,然后再次分配page并从backup的磁盘中加载该page的数据,返回异常的现场。
      • qkhhyga

        @郭健:Hi,linuxer 但该用户程序再次执行的时候,访问正文段产生异常,然后再次分配page并从backup的磁盘中加载该page的数据,返回异常的现场。 》》》我想问问,在回收page时,会把page 的内存backup到磁盘吗?
        • linuxer

          @qkhhyga:正文段是read only的,不会被修改,因此不需要讲page上的内容backup到磁盘。
          • qkhhyga

            @linuxer:Hi,linux,应用层的函数栈在该函数末退出时,这种情况的栈page 是否会被回收?又是如何来判断这种page 是否可以被回收呢? 别外,我们都知道,应用程序在堆分配出来的内存属于匿名页面,这种页面又是如何设置page的count和mapcount参数的?
            • linuxer

              @qkhhyga:栈上的page属于匿名映射,只要内核配置了swap on,那么所有匿名page都会拥有了backup file或者backup device,只要有了backup file或者backup device,一般情况下(没有锁住)都可以被回收。 mapcount参数是和地址映射相关的,在为该page创建新的地址映射关系的时候,会累加mapcount。 count是真正的,通用意义上的reference counter。
              • qkhhyga

                @linuxer:Hi,linuxer 非常感谢你的回复   count 在什么时候加一,减一又是什么时候?初始时,count是多少?当上层应用在执行free 的时候是否会对count 进行减一操作?
              • linuxer

                @linuxer:一个物理页面(page frame)是由struct page来抽象,其成员_count表示了该page frame被使用的次数。刚开始,一个物理页面不被任何进程使用,_count等于-1,一旦被分配给了某个进程(我们称之A进程),例如保存了data段的数据,那么该page frame的_count等于0。在进程fork的时候,新进程B产生了,由于COW的原因,两个进程的地址空间都指向了一个page frame,那么这时候,该page frame的_count就会加一。当B进程向data段写入的时候,会产生memory fault,然后会为B进程分配新的page frame,从而使得A和B不再共享一个page frame,那么旧的page的_count就会减一。 应用调用memory和free的时候,分配的都是虚拟地址,和物理页帧没有任何的关系
              • qkhhyga

                @linuxer:我在看shrink_page_list 的时候,发现只有在page—>_count 等于0时才会被释放,这里有个疑问,既然还有进程引用这个page,那么为什么还会释放? 当然shrink_page_list是在shrink_inactive_list 中调用的,是否在内存回收时并不在乎_count 的值,如果等于1或者2,只要try_to_unmap就可以了?
  • andy01011501

    我想保持一个普通文件在内存中的cache不被置换,也就是永久保留在内存中,有没有什么好办法啊?
    • itrocker

      @andy01011501:可以使用mlock机制
      • andy01011501

        @itrocker:对,非常感谢
  • keiviw

    您好 有个关于dentrycache和inodecache的内存回收问题请教您,在内存回收分配的dentry对象时,回收条件是什么?回收时针对的是memory_area还是page
    • wowo

      @keiviw:文件系统有关的回收操作,是由vm触发的(可参考shrink_slab-->do_shrinker_shrink-->shrinker->shrink),但具体的回收动作,是由文件系统负责的(可参考fs/super.c中的prune_super接口)。 也就是说,decache和inode回收时机,是文件系统自己的事情,和vm无关。而具体的回收行为,我也没有研究过,你可以试试自己看一下。
      • keiviw

        @wowo:您看的源码是什么版本?我的理解是shrink_dcache_memory回收dentry对象到slab分配池中,而您介绍的cache_reap是针对slab3链表的空链表回收页帧
        • wowo

          @keiviw:我看的内核版本是linux-4.0.5,里面已经没有你说的shrink_dcache_memory接口了。
  • linux小白

    休眠的时间是HZ/10,对于arm(HZ=100)来说,休眠的时间就是1ms。 应该是10ms吧
    • bsp

      @linux小白:休眠的时间是HZ/10,对于arm(HZ=100)来说,休眠的时间就是100ms。 1HZ是1s,HZ/10当然是100ms。 而且不管对于arm还是x86,HZ/10都是100ms。
    • zhaoge.zhang

      @linux小白:休眠的时间是HZ/10,对于arm(HZ=100)来说,休眠的时间就是1ms。 1.对于arm(HZ=100),所以可以得出100 * HZ = 1 S,所以 HZ = 10 ms 2.休眠的时间是HZ/10,所以休眠时间 = HZ / 10 = 10 ms / 10 = 1 ms
  • linux小白

    @itrocker 之后休眠2*HZ,对于arm(HZ=100)来说,周期就是20ms。 休眠的时间是HZ/10,对于arm(HZ=100)来说,休眠的时间就是1ms。 我理解HZ ARM中定义是100, 相当于1S内产生100个时钟中断,jiffies = 1S/100 = 10, 所以一个jiffes代表10ms, HZ是100个jiffes 等于1s,所以2HZ=2S, 但看您的计算HZ=1S/100 = 10MS, 难道我之前理解都错了么。。。请帮忙再普及下HZ,JIFFIES概念,谢谢~
    • davidlamb

      @linux小白:我觉得你的理解是正确的。
  • tiger

    没太明白page_referenced是在什么时候调用的?是每次回收页面的时候遍历这些可回收的页面时候调用的么?
    • bsp

      @tiger:有一处是在shrink_active_list中调用的,也就是内存不够时 先尝试从inactive中回收,但是inactive也不够 再调用shrink_active_list去move_active_pages_to_lru。
  • zhenhua

    貌似现在page_referenced不会做ClearPageReferenced的动作,而是在page_check_references去做 而且现在inactive -> active 的转移除了mark_page_accessed,在shrink_page_list也有体现。 所以上面那张图貌似是老了,期待更新哈
  • tigerbear

    请教个问题, 1. 你提到kswapd会周期性的回收,并且正常情况下回收的周期是100ms。但是我代码中(kswapd_try_to_sleep)看到似乎是kswapd会先睡眠100ms,如果睡眠过程中没有被唤醒的话就永久进入睡眠,直到下一次被唤醒。这是否与你说的周期性回收相矛盾呢? 2. 我这边碰到一个问题,就是有时候会有突发性的GFP_ATOMIC标志的大量分配内存的需求,虽然每次分配只要一个页面,但会一下子要求分配很多。这种情况下我经常看到即使kswapd在工作,似乎回收速度也赶不上分配的速度,因此会造成分配失败。这个有什么办法能改善么?谢谢!
  • firo

    我查了4.19的代码, page_referenced逻辑没变, 依然适用.
  • Second2None

    page_referenced通过PTE中一个硬件标志位来判断页面的访问频率。对于KVM虚拟机访问某个页面,如果此时对应的ept页表项已经存在,TLB脱靶,访问的是gpte和spte,并没有用到宿主机的pte。page_referenced有考虑这种情况吗?KVM虚拟机页面回收还有第二次机会吗?宿主机是如何得知虚拟机访问过这个物理页面被访问过的呢?
    • bsp

      @Second2None:arm64的虚拟化中有stage2映射,mmu可以认为也有两级; 虚拟机通过VA得到IPA(你说的gpte/spte/pte)后,宿主机中的stage2页表负责IPA到PA(同理有另外一套页表map机制),host可以感知到IPA的PA的访问,同理加个硬件标志位 即可。
      • Second2None

        @bsp:是的,host硬件可以感知到IPA到PA的访问过程。但是,对于一个虚拟机的页面,在宿主机上是存在两个对应的页表项的,s2pte:IPA到PA的映射,pte:HVA到PA的映射,我看源码好像并没有判断某个页面是虚拟机使用的还是普通应用在使用。如果是虚拟机在使用那么page_referenced应该去判断stage2页表,如果是普通应用在使用,那么应该去判断stage1页表。