Linux内核的自旋锁
作者简介:余华兵,在网络通信行业工作十多年,负责IPv4协议栈、IPv6协议栈和Linux内核。在工作中看着2.6版本的专业书籍维护3.x和4.x版本的Linux内核,感觉不方便,于是自己分析4.x版本的Linux内核整理出一本书,书名叫《Linux内核深度解析》,2019年5月出版,希望对同行有帮助。
自旋锁用于处理器之间的互斥,适合保护很短的临界区,并且不允许在临界区睡眠。申请自旋锁的时候,如果自旋锁被其他处理器占有,本处理器自旋等待(也称为忙等待)。
进程、软中断和硬中断都可以使用自旋锁。
自旋锁的实现经历了3个阶段:
(1)最早的自旋锁是无序竞争的,不保证先申请的进程先获得锁。
(2)第2个阶段是入场券自旋锁,进程按照申请锁的顺序排队,先申请的进程先获得锁。
(3)第3个阶段是MCS自旋锁。入场券自旋锁存在性能问题:所有申请锁的处理器在同一个变量上自旋等待,缓存同步的开销大,不适合处理器很多的系统。MCS自旋锁的策略是为每个处理器创建一个变量副本,每个处理器在自己的本地变量上自旋等待,解决了性能问题。
入场券自旋锁和MCS自旋锁都属于排队自旋锁(queued spinlock),进程按照申请锁的顺序排队,先申请的进程先获得锁。
1. 数据结构
自旋锁的定义如下:
include/linux/spinlock**_types.h**
typedef struct spinlock {
union {
struct raw_spinlock rlock;
…
};
} spinlock_t;
typedef struct raw_spinlock {
arch_spinlock_t raw_lock;
…
} raw_spinlock_t;
可以看到,数据类型spinlock对raw_spinlock做了封装,然后数据类型raw_spinlock对arch_spinlock_t做了封装,各种处理器架构需要自定义数据类型arch_spinlock_t。
spinlock和raw_spinlock(原始自旋锁)有什么关系?
Linux内核有一个实时内核分支(开启配置宏CONFIG_PREEMPT_RT)来支持硬实时特性,内核主线只支持软实时。
对于没有打上实时内核补丁的内核,spinlock只是封装raw_spinlock,它们完全一样。如果打上实时内核补丁,那么spinlock使用实时互斥锁保护临界区,在临界区内可以被抢占和睡眠,但raw_spinlock还是自旋锁。
目前主线版本还没有合并实时内核补丁,说不定哪天就会合并进来,为了使代码可以兼容实时内核,最好坚持3个原则:
(1)尽可能使用spinlock。
(2)绝对不允许被抢占和睡眠的地方,使用raw_spinlock,否则使用spinlock。
(3)如果临界区足够小,使用raw_spinlock。
2. 使用方法
定义并且初始化静态自旋锁的方法是:
DEFINE_SPINLOCK(x);
在运行时动态初始化自旋锁的方法是:
spin_lock_init(x);
申请自旋锁的函数是:
(1)void spin_lock(spinlock_t *lock);
申请自旋锁,如果锁被其他处理器占有,当前处理器自旋等待。
(2)void spin_lock_bh(spinlock_t *lock);
申请自旋锁,并且禁止当前处理器的软中断。
(3)void spin_lock_irq(spinlock_t *lock);
申请自旋锁,并且禁止当前处理器的硬中断。
(4)spin_lock_irqsave(lock, flags);
申请自旋锁,保存当前处理器的硬中断状态,并且禁止当前处理器的硬中断。
(5)int spin_trylock(spinlock_t *lock);
申请自旋锁,如果申请成功,返回1;如果锁被其他处理器占有,当前处理器不等待,立即返回0。
释放自旋锁的函数是:
(1)void spin_unlock(spinlock_t *lock);
(2)void spin_unlock_bh(spinlock_t *lock);
释放自旋锁,并且开启当前处理器的软中断。
(3)void spin_unlock_irq(spinlock_t *lock);
释放自旋锁,并且开启当前处理器的硬中断。
(4)void spin_unlock_irqrestore(spinlock_t *lock, unsigned long flags);
释放自旋锁,并且恢复当前处理器的硬中断状态。
定义并且初始化静态原始自旋锁的方法是:
DEFINE_RAW_SPINLOCK(x);
在运行时动态初始化原始自旋锁的方法是:
raw_spin_lock_init (x);
申请原始自旋锁的函数是:
(1)raw_spin_lock(lock)
申请原始自旋锁,如果锁被其他处理器占有,当前处理器自旋等待。
(2)raw_spin_lock_bh(lock)
申请原始自旋锁,并且禁止当前处理器的软中断。
(3)raw_spin_lock_irq(lock)
申请原始自旋锁,并且禁止当前处理器的硬中断。
(4)raw_spin_lock_irqsave(lock, flags)
申请原始自旋锁,保存当前处理器的硬中断状态,并且禁止当前处理器的硬中断。
(5)raw_spin_trylock(lock)
申请原始自旋锁,如果申请成功,返回1;如果锁被其他处理器占有,当前处理器不等待,立即返回0。
释放原始自旋锁的函数是:
(1)raw_spin_unlock(lock)
(2)raw_spin_unlock_bh(lock)
释放原始自旋锁,并且开启当前处理器的软中断。
(3)raw_spin_unlock_irq(lock)
释放原始自旋锁,并且开启当前处理器的硬中断。
(4)raw_spin_unlock_irqrestore(lock, flags)
释放原始自旋锁,并且恢复当前处理器的硬中断状态。
3. 入场券自旋锁
入场券自旋锁(ticket spinlock)的算法类似于银行柜台的排队叫号:
(1)锁拥有排队号和服务号,服务号是当前占有锁的进程的排队号。
(2)每个进程申请锁的时候,首先申请一个排队号,然后轮询锁的服务号是否等于自己的排队号,如果等于,表示自己占有锁,可以进入临界区,否则继续轮询。
(3)当进程释放锁时,把服务号加一,下一个进程看到服务号等于自己的排队号,退出自旋,进入临界区。
ARM64架构定义的数据类型arch_spinlock_t如下所示:
arch/arm64/include/asm/spinlock**_types.h**
typedef struct {
#ifdef __AARCH64EB__ /* 大端字节序(高位存放在低地址) */
u16 next;
u16 owner;
#else /* 小端字节序(低位存放在低地址) */
u16 owner;
u16 next;
#endif
} __aligned(4) arch_spinlock_t;
成员next是排队号,成员owner是服务号。
在多处理器系统中,函数spin_lock()负责申请自旋锁,ARM64架构的代码如下所示:
spin_lock() -> raw_spin_lock() -> _raw_spin_lock() -> __raw_spin_lock() -> do_raw_spin_lock() -> arch_spin_lock()
arch/arm64/include/asm/spinlock.h
1 static inline void arch_spin_lock(arch_spinlock_t *lock)
2 {
3 unsigned int tmp;
4 arch_spinlock_t lockval, newval;
5
6 asm volatile(
7 ARM64_LSE_ATOMIC_INSN(
8 /* LL/SC */
9 " prfm pstl1strm, %3\n"
10 “1: ldaxr %w0, %3\n”
11 " add %w1, %w0, %w5\n"
12 " stxr %w2, %w1, %3\n"
13 " cbnz %w2, 1b\n",
14 /* 大系统扩展的原子指令 */
15 " mov %w2, %w5\n"
16 " ldadda %w2, %w0, %3\n"
17 __nops(3)
18 )
19
20 /* 我们得到锁了吗?*/
21 " eor %w1, %w0, %w0, ror #16\n"
22 " cbz %w1, 3f\n"
23 " sevl\n"
24 “2: wfe\n”
25 " ldaxrh %w2, %4\n"
26 " eor %w1, %w2, %w0, lsr #16\n"
27 " cbnz %w1, 2b\n"
28 /* 得到锁,临界区从这里开始*/
29 “3:”
30 : “=&r” (lockval), “=&r” (newval), “=&r” (tmp), “+Q” (*lock)
31 : “Q” (lock->owner), “I” (1 « TICKET_SHIFT)
32 : “memory”);
33 }
第6~18行代码,申请排队号,然后把自旋锁的排队号加1,这是一个原子操作,有两种实现方法:
1)第9~13行代码,使用指令ldaxr(带有获取语义的独占加载)和stxr(独占存储)实现,指令ldaxr带有获取语义,后面的加载/存储指令必须在指令ldaxr完成之后开始执行。
2)第15~16行代码,如果处理器支持大系统扩展,那么使用带有获取语义的原子加法指令ldadda实现,指令ldadda带有获取语义,后面的加载/存储指令必须在指令ldadda完成之后开始执行。
第21~22行代码,如果服务号等于当前进程的排队号,进入临界区。
第24~27行代码,如果服务号不等于当前进程的排队号,那么自旋等待。使用指令ldaxrh(带有获取语义的独占加载,h表示halfword,即2字节)读取服务号,指令ldaxrh带有获取语义,后面的加载/存储指令必须在指令ldaxrh完成之后开始执行。
第23行代码,sevl(send event local)指令的功能是发送一个本地事件,避免错过其他处理器释放自旋锁时发送的事件。
第24行代码,wfe(wait for event)指令的功能是使处理器进入低功耗状态,等待事件。
函数spin_unlock()负责释放自旋锁,ARM64架构的代码如下所示:
spin_unlock() -> raw_spin_unlock() -> _raw_spin_unlock() -> __raw_spin_unlock() -> do_raw_spin_unlock() -> arch_spin_unlock()
arch/arm64/include/asm/spinlock.h
1 static inline void arch_spin_unlock(arch_spinlock_t *lock)
2 {
3 unsigned long tmp;
4
5 asm volatile(ARM64_LSE_ATOMIC_INSN(
6 /* LL/SC */
7 " ldrh %w1, %0\n"
8 " add %w1, %w1, #1\n"
9 " stlrh %w1, %0",
10 /* 大多统扩展的原子指令 */
11 " mov %w1, #1\n"
12 " staddlh %w1, %0\n"
13 __nops(1))
14 : “=Q” (lock->owner), “=&r” (tmp)
15 :
16 : “memory”);
17 }
把自旋锁的服务号加1,有两种实现方法:
(1)第7~9行代码,使用指令ldrh(加载,h表示halfword,即2字节)和stlrh(带有释放语义的存储)实现,指令stlrh带有释放语义,前面的加载/存储指令必须在指令stlrh开始执行之前执行完。因为一次只能有一个进程进入临界区,所以只有一个进程把自旋锁的服务号加1,不需要是原子操作。
(2)第11~12行代码,如果处理器支持大系统扩展,那么使用带有释放语义的原子加法指令staddlh实现,指令staddlh带有释放语义,前面的加载/存储指令必须在指令staddlh开始执行之前执行完。
在单处理器系统中,自旋锁是空的。
include/linux/spinlock**_types****_up.h**
typedef struct { } arch_spinlock_t;
函数spin_lock()只是禁止内核抢占。
spin_lock() -> raw_spin_lock() -> _raw_spin_lock()
include/linux/spinlock**_api****_up.h**
#define _raw_spin_lock(lock) __LOCK(lock)
#define __LOCK(lock) \
do { preempt**_disable();**___LOCK(lock); } while (0)
#define ___LOCK(lock) \
do { __acquire(lock); (void)(lock); } while (0)
4. MCS自旋锁
入场券自旋锁存在性能问题:所有等待同一个自旋锁的处理器在同一个变量上自旋等待,申请或者释放锁的时候会修改锁,导致其他处理器存放自旋锁的缓存行失效,在拥有几百甚至几千个处理器的大型系统中,处理器申请自旋锁时竞争可能很激烈,缓存同步的开销很大,导致系统性能大幅度下降。
MCS(MCS是“Mellor-Crummey”和“Scott”这两个发明人的名字的首字母缩写)自旋锁解决了这个缺点,它的策略是为每个处理器创建一个变量副本,每个处理器在申请自旋锁的时候在自己的本地变量上自旋等待,避免缓存同步的开销。
4.1.传统的MCS自旋锁
传统的MCS自旋锁包含:
(1)一个指针tail指向队列的尾部。
(2)每个处理器对应一个队列节点,即mcs_lock_node结构体,其中成员next指向队列的下一个节点,成员locked指示锁是否被其他处理器占有,如果成员locked的值为1,表示锁被其他处理器占有。
结构体的定义如下所示:
typedef struct __mcs_lock_node {
struct __mcs_lock_node *next;
int locked;
} ____cacheline_aligned_in_smp mcs_lock_node;
typedef struct {
mcs_lock_node *tail;
mcs_lock_node nodes[NR_CPUS];/* NR_CPUS是处理器的数量 */
} spinlock_t;
其中“____cacheline_aligned_in_smp”的作用是:在多处理器系统中,结构体的起始地址和长度都是一级缓存行长度的整数倍。
当没有处理器占有或者等待自旋锁的时候,队列是空的,tail是空指针。
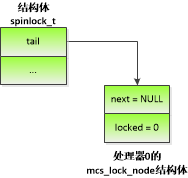
图4.1处理器0申请MCS自旋锁
如图 4.1所示,当处理器0申请自旋锁的时候,执行原子交换操作,使tail指向处理器0的mcs_lock_node结构体,并且返回tail的旧值。tail的旧值是空指针,说明自旋锁处于空闲状态,那么处理器0获得自旋锁。
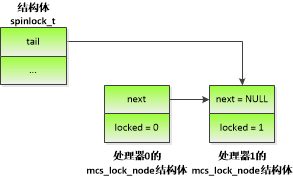
图4.2处理器1申请MCS自旋锁
如图 4.2所示,当处理器0占有自旋锁的时候,处理器1申请自旋锁,执行原子交换操作,使tail指向处理器1的mcs_lock_node结构体,并且返回tail的旧值。tail的旧值是处理器0的mcs_lock_node结构体的地址,说明自旋锁被其他处理器占有,那么使处理器0的mcs_lock_node结构体的成员next指向处理器1的mcs_lock_node结构体,把处理器1的mcs_lock_node结构体的成员locked设置为1,然后处理器1在自己的mcs_lock_node结构体的成员locked上面自旋等待,等待成员locked的值变成0。
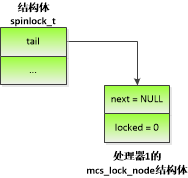
图4.3处理器0释放MCS自旋锁
如图 4.3所示,处理器0释放自旋锁,发现自己的mcs_lock_node结构体的成员next不是空指针,说明有申请者正在等待锁,于是把下一个节点的成员locked设置为0,处理器1获得自旋锁。
处理器1释放自旋锁,发现自己的mcs_lock_node结构体的成员next是空指针,说明自己是最后一个申请者,于是执行原子比较交换操作:如果tail指向自己的mcs_lock_node结构体,那么把tail设置为空指针。
4.2.小巧的MCS自旋锁
传统的MCS自旋锁存在的缺陷是:结构体的长度太大,因为mcs_lock_node结构体的起始地址和长度都必须是一级缓存行长度的整数倍,所以MCS自旋锁的长度是(一级缓存行长度 + 处理器数量 * 一级缓存行长度),而入场券自旋锁的长度只有4字节。自旋锁被嵌入到内核的很多结构体中,如果自旋锁的长度增加,会导致这些结构体的长度增加。
经过内核社区技术专家的努力,成功地把MCS自旋锁放进4个字节,实现了小巧的MCS自旋锁。自旋锁的定义如下所示:
include/asm-generic/qspinlock_types.h
typedef struct qspinlock {
atomic_tval;
} arch_spinlock_t;
另外,为每个处理器定义1个队列节点数组,如下所示:
kernel/locking/qspinlock.c
#ifdef CONFIG_PARAVIRT_SPINLOCKS
#define MAX_NODES8
#else
#define MAX_NODES4
#endif
static DEFINE_PER_CPU_ALIGNED(struct mcs_spinlock, mcs_nodes[MAX_NODES]);
配置宏CONFIG_PARAVIRT_SPINLOCKS用来启用半虚拟化的自旋锁,给虚拟机使用,本文不考虑这种使用场景。每个处理器需要4个队列节点,原因如下:
(1)申请自旋锁的函数禁止内核抢占,所以进程在等待自旋锁的过程中不会被其他进程抢占。
(2)进程在等待自旋锁的过程中可能被软中断抢占,然后软中断等待另一个自旋锁。
(3)软中断在等待自旋锁的过程中可能被硬中断抢占,然后硬中断等待另一个自旋锁。
(4)硬中断在等待自旋锁的过程中可能被不可屏蔽中断抢占,然后不可屏蔽中断等待另一个自旋锁。
综上所述,一个处理器最多同时等待4个自旋锁。
和入场券自旋锁相比,MCS自旋锁增加的内存开销是数组mcs_nodes。
队列节点的定义如下所示:
kernel/locking/mcs_spinlock.h
struct mcs_spinlock {
struct mcs_spinlock *next;
int locked;
int count;
};
其中成员next指向队列的下一个节点;成员locked指示锁是否被前一个等待者占有,如果值为1,表示锁被前一个等待者占有;成员count是嵌套层数,也就是数组mcs_nodes已分配的数组项的数量。
自旋锁的32个二进制位被划分成4个字段:
(1)locked字段,指示锁已经被占有,长度是一个字节,占用第0~7位。
(2)一个pending位,占用第8位,第1个等待自旋锁的处理器设置pending位。
(3)index字段,是数组索引,指示队列的尾部节点使用数组mcs_nodes的哪一项。
(4)cpu字段,存放队列的尾部节点的处理器编号,实际存储的值是处理器编号加上1,cpu字段减去1才是真实的处理器编号。
index字段和cpu字段合起来称为tail字段,存放队列的尾部节点的信息,布局分两种情况:
(1)如果处理器的数量小于2的14次方,那么第915位没有使用,第1617位是index字段,第18~31位是cpu字段。
(2)如果处理器的数量大于或等于2的14次方,那么第910位是index字段,第1131位是cpu字段。
把MCS自旋锁放进4个字节的关键是:存储处理器编号和数组索引,而不是存储尾部节点的地址。
内核对MCS自旋锁做了优化:第1个等待自旋锁的处理器直接在锁自身上面自旋等待,不是在自己的mcs_spinlock结构体上自旋等待。这个优化带来的好处是:当锁被释放的时候,不需要访问mcs_spinlock结构体的缓存行,相当于减少了一次缓存没命中。后续的处理器在自己的mcs_spinlock结构体上面自旋等待,直到它们移动到队列的首部为止。
自旋锁的pending位进一步扩展这个优化策略。第1个等待自旋锁的处理器简单地设置pending位,不需要使用自己的mcs_spinlock结构体。第2个处理器看到pending被设置,开始创建等待队列,在自己的mcs_spinlock结构体的locked字段上自旋等待。这种做法消除了两个等待者之间的缓存同步,而且第1个等待者没使用自己的mcs_spinlock结构体,减少了一次缓存行没命中。
在多处理器系统中,申请MCS自旋锁的代码如下所示:
spin_lock() -> raw_spin_lock() -> _raw_spin_lock() -> __raw_spin_lock() -> do_raw_spin_lock() -> arch_spin_lock()
include/asm-generic/qspinlock.h
1#define arch_spin_lock(l)queued_spin_lock(l)
2
3static __always_inline void queued_spin_lock(struct qspinlock *lock)
4{
5u32 val;
6
7val = atomic_cmpxchg_acquire(&lock->val, 0, _Q_LOCKED_VAL);
8if (likely(val == 0))
9return;
10queued_spin_lock_slowpath(lock, val);
11}
第7行代码,执行带有获取语义的原子比较交换操作,如果锁的值是0,那么把锁的locked字段设置为1。获取语义保证后面的加载/存储指令必须在函数atomic_cmpxchg_acquire()完成之后开始执行。函数atomic_cmpxchg_acquire()返回锁的旧值。
第8~9行代码,如果锁的旧值是0,说明申请锁的时候锁处于空闲状态,那么成功地获得锁。
第10行代码,如果锁的旧值不是0,说明锁不是处于空闲状态,那么执行申请自旋锁的慢速路径。
申请MCS自旋锁的慢速路径如下所示:
kernel/locking/qspinlock.c
1void queued_spin_lock_slowpath(struct qspinlock *lock, u32 val)
2{
3struct mcs_spinlock *prev, *next, *node;
4u32 new, old, tail;
5int idx;
6
7…
8if (val == _Q_PENDING_VAL) {
9while ((val = atomic_read(&lock->val)) == _Q_PENDING_VAL)
10cpu_relax();
11}
12
13for (;;) {
14if (val & ~_Q_LOCKED_MASK)
15goto queue;
16
17new = _Q_LOCKED_VAL;
18if (val == new)
19new |= _Q_PENDING_VAL;
20
21old = atomic_cmpxchg_acquire(&lock->val, val, new);
22if (old == val)
23break;
24
25val = old;
26}
27
28if (new == _Q_LOCKED_VAL)
29return;
30
31smp_cond_load_acquire(&lock->val.counter, !(VAL & _Q_LOCKED_MASK));
32
33clear_pending_set_locked(lock);
34return;
35
36queue:
37node = this_cpu_ptr(&mcs_nodes[0]);
38idx = node->count++;
39tail = encode_tail(smp_processor_id(), idx);
40
41node += idx;
42node->locked = 0;
43node->next = NULL;
44…
45
46if (queued_spin_trylock(lock))
47goto release;
48
49old = xchg_tail(lock, tail);
50next = NULL;
51
52if (old & _Q_TAIL_MASK) {
53prev = decode_tail(old);
54smp_read_barrier_depends();
55
56WRITE_ONCE(prev->next, node);
57
58…
59arch_mcs_spin_lock_contended(&node->locked);
60
61next = READ_ONCE(node->next);
62if (next)
63prefetchw(next);
64}
65
66…
67val = smp_cond_load_acquire(&lock->val.counter, !(VAL & _Q_LOCKED_PENDING_MASK));
68
69locked:
70for (;;) {
71if ((val & _Q_TAIL_MASK) != tail) {
72set_locked(lock);
73break;
74}
75
76old = atomic_cmpxchg_relaxed(&lock->val, val, _Q_LOCKED_VAL);
77if (old == val)
78goto release;
79
80val = old;
81}
82
83if (!next) {
84while (!(next = READ_ONCE(node->next)))
85cpu_relax();
86}
87
88arch_mcs_spin_unlock_contended(&next->locked);
89…
90
91release:
92__this_cpu_dec(mcs_nodes[0].count);
93}
第8~11行代码,如果锁的状态是pending,即{tail=0,pending=1,locked=0},那么等待锁的状态变成locked,即{tail=0,pending=0,locked=1}。
第14~15行代码,如果锁的tail字段不是0或者pending位是1,说明已经有处理器在等待自旋锁,那么跳转到标号queue,本处理器加入等待队列。
第17~21行代码,如果锁处于locked状态,那么把锁的状态设置为locked & pending,即{tail=0,pending=1,locked=1};如果锁处于空闲状态(占有锁的处理器刚刚释放自旋锁),那么把锁的状态设置为locked。
第28~29行代码,如果上一步锁的状态从空闲变成locked,那么成功地获得锁。
第31行代码,等待占有锁的处理器释放自旋锁,即锁的locked字段变成0。
第32行代码,成功地获得锁,把锁的状态从pending改成locked,即清除pending位,把locked字段设置为1。
从第2个等待自旋锁的处理器开始,需要加入等待队列,处理如下:
(1)第37~43行代码,从本处理器的数组mcs_nodes分配一个数组项,然后初始化。
(2)第46~47行代码,如果锁处于空闲状态,那么获得锁。
(3)第49行代码,把自旋锁的tail字段设置为本处理器的队列节点的信息,并且返回前一个队列节点的信息。
(4)第52行代码,如果本处理器的队列节点不是队列首部,那么处理如下:
1)第56行代码,把前一个队列节点的next字段设置为本处理器的队列节点的地址。
2)第59行代码,本处理器在自己的队列节点的locked字段上面自旋等待,等待locked字段从0变成1,也就是等待本处理器的队列节点移动到队列首部。
(5)第67行代码,本处理器的队列节点移动到队列首部以后,在锁自身上面自旋等待,等待自旋锁的pending位和locked字段都变成0,也就是等待锁的状态变成空闲。
(6)锁的状态变成空闲以后,本处理器把锁的状态设置为locked,分两种情况:
1)第71行代码,如果队列还有其他节点,即还有其他处理器在等待锁,那么处理如下:
q第72行代码,把锁的locked字段设置为1。
q第83~86行代码,等待下一个等待者设置本处理器的队列节点的next字段。
q第88行代码,把下一个队列节点的locked字段设置为1。
2)第76行代码,如果队列只有一个节点,即本处理器是唯一的等待者,那么把锁的tail字段设置为0,把locked字段设置为1。
(7)第92行代码,释放本处理器的队列节点。
释放MCS自旋锁的代码如下所示:
spin_unlock() -> raw_spin_unlock() -> _raw_spin_unlock() -> __raw_spin_unlock() -> do_raw_spin_unlock() -> arch_spin_unlock()
include/asm-generic/qspinlock.h
1#define arch_spin_unlock(l)queued_spin_unlock(l)
2
3static __always_inline void queued_spin_unlock(struct qspinlock *lock)
4{
5(void)atomic_sub_return_release(_Q_LOCKED_VAL, &lock->val);
6}
第5行代码,执行带释放语义的原子减法操作,把锁的locked字段设置为0,释放语义保证前面的加载/存储指令在函数atomic_sub_return_release()开始执行之前执行完。
MCS自旋锁的配置宏是CONFIG_ARCH_USE_QUEUED_SPINLOCKS 和CONFIG_QUEUED_SPINLOCKS,目前只有x86处理器架构使用MCS自旋锁,默认开启MCS自旋锁的配置宏,如下所示:
arch/x86/kconfig
config X86
def_bool y
…
select ARCH_USE_QUEUED_SPINLOCKS
…
kernel/kconfig.locks
config ARCH_USE_QUEUED_SPINLOCKS
bool
config QUEUED_SPINLOCKS
def_bool y if ARCH_USE_QUEUED_SPINLOCKS
depends on SMP
继续讨论
新讨论请用 GitHub 账号在下方发言——评论会保存在本仓库的 Discussions 里,与站点同寿; 再下方的「历史评论」是原站的只读存档。
评论(13 条,只读存档)
以下为原站的历史评论(只读存档);继续讨论请用上方的评论区。
Totti_IT
沙漠之狐
wang
沙漠之狐
wang
aaron0905
firo
沙漠之狐
jxh218@163.com
沙漠之狐
see
bdfail 主页
沙漠之狐