蜗窝科技

ARM64的启动过程之(四):打开MMU

linuxer · · ARMv8A Arch · 阅读 66894 · 2015年10月存档

一、前言

经过漫长的前戏,我们终于迎来了打开MMU的时刻,本文主要描述打开MMU以及跳转到start_kernel之前的代码逻辑。这一节完成之后,我们就会离开痛苦的汇编,进入人民群众喜闻乐见的c代码了。

二、打开MMU前后的概述

对CPU以及其执行的程序而言,打开MMU是一件很有意思的事情,好象从现实世界一下子走进了奇妙的虚幻世界,本节,我们一起来看看内核是如何“穿越”的。下面这张图描述了两个不同的世界:

mmu-on-off

当没有打开MMU的时候,cpu在进行取指以及数据访问的时候是直接访问物理内存或者IO memory。虽然64bit的CPU理论上拥有非常大的address space,但是实际上用于存储kernel image的物理main memory并没有那么大,一般而言,系统的main memory在低端的一小段物理地址空间中,如上图右侧的图片所示。当打开MMU的时候,cpu对memory系统的访问不能直接触及物理空间,而是需要通过一系列的Translation table进行翻译。虚拟地址空间分成三段,低端是0x00000000_00000000~0x0000FFFF_FFFFFFFF,用于user space。高端是0xFFFF0000_00000000~0xFFFFFFFF_FFFFFFFF,用于kernel space。中间的一段地址是无效地址,对其访问会产生MMU fault。虚拟地址空间如上图右侧的图片所示。

Linker感知的是虚拟地址,在将内核的各个object文件链接成一个kernel image的时候,kernel image binary code中访问的都是虚拟地址,也就是说kernel image应该运行在Linker指定的虚拟地址空间上。问题来了,kernel image运行在那个地址上呢?实际上,将kernel image放到kernel space的首地址运行是一个最直观的想法,不过由于各种原因,具体的arch在编译内核的时候,可以指定一个offset(TEXT_OFFSET),对于ARM64而言是512KB(0x00080000),因此,编译后的内核运行在0xFFFF8000_00080000的地址上。系统启动后,bootloader会将kernel image copy到main memory,当然,和虚拟地址空间类似,kernel image并没有copy到main memory的首地址,也保持了一个同样size的offset。现在,问题又来了:在kernel的开始运行阶段,MMU是OFF的,也就是说kernel image是直接运行在物理地址上的,但是实际上kernel是被linker链接到了虚拟地址上去的,在这种情况下,在没有turn on MMU之前,kernel能正常运行吗?可以的,如果kernel在turn on MMU之前的代码都是PIC的,那么代码实际上是可以在任意地址上运行的。你可以仔细观察turn on MMU之前的代码,都是位置无关的代码。

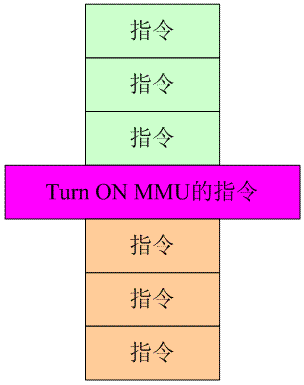
OK,解决了MMU turn on之前的问题,现在我们可以准备“穿越”了。真正打开MMU就是一条指令而已,就是将某个system register的某个bit设定为1之类的操作。这样我们可以把相关指令分成两组,turn on mmu之前的绿色指令和之后的橘色指令,如下图所示:
mmu-1

由于现代CPU的设计引入了pipe, super scalar,out-of-order execution,分支预测等等特性,实际上在turn on MMU的指令执行的那个时刻,该指令附近的指令的具体状态有些混乱,可能绿色指令执行的数据加载在实际在总线上发起bus transaction的时候已经启动了MMU,本来它是应该访问physical address space的。而也有可能橘色的指令提前执行,导致其发起的memory操作在MMU turn on之前就完成。为了解决这些混乱,可以采取一种投机取巧的办法,就是建立一致性映射:假设kernel image对应的物理地址段是A~B这一段,那么在建立页表的时候就把A~B这段虚拟地址段映射到A~B这一段的物理地址。这样,在turn on MMU附近的指令是毫无压力的,无论你是通过虚拟地址还是物理地址,访问的都是同样的物理memory。

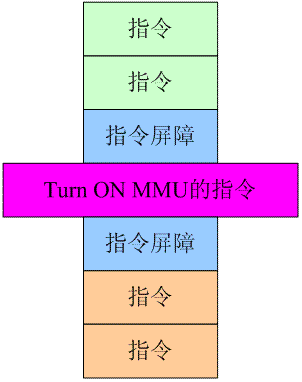
还有一种方法,就是清楚的隔离turn on MMU前后的指令,那就是使用指令同步工具,如下:
mmu-2

指令屏障可以清清楚楚的把指令的执行划分成三段,第一段是绿色指令,在执行turn on mmu指令执行之前全部完成,随后启动turn on MMU的指令,随后的指令屏障可以确保turn on MMU的指令完全执行完毕(整个计算机系统的视图切换到了虚拟世界),这时候才启动橘色指令的取指、译码、执行等操作。

三、打开MMU的代码

具体打开MMU的代码在__enable_mmu函数中如下:

__enable_mmu:
ldr x5, =vectors
msr vbar_el1, x5 ---------------------------(1)
msr ttbr0_el1, x25 // load TTBR0 -----------------(2)
msr ttbr1_el1, x26 // load TTBR1
isb
msr sctlr_el1, x0 ---------------------------(3)
isb
br x27 -------------跳转到__mmap_switched执行,不设定lr寄存器
ENDPROC(__enable_mmu)

传入该函数的参数有四个,一个是x0寄存器,该寄存器中保存了打开MMU时候要设定的SCTLR_EL1的值(在__cpu_setup函数中设定),第二个是个是x25寄存器,保存了idmap_pg_dir的值。第三个参数是x26寄存器,保存了swapper_pg_dir的值。最后一个参数是x27,是执行完毕该函数之后,跳转到哪里去执行(__mmap_switched)。

(1)VBAR_EL1, Vector Base Address Register (EL1),该寄存器保存了EL1状态的异常向量表。在ARMv8中,发生了一个exception,首先需要确定的是该异常将送达哪一个exception level。如果一个exception最终送达EL1,那么cpu会跳转到这里向量表来执行。具体异常的处理过程由其他文档描述,这里就不说了。

(2)idmap_pg_dir是为turn on MMU准备的一致性映射,物理地址的高16bit都是0,因此identity mapping必定是选择TTBR0_EL1指向的各级地址翻译表。后续当系统运行之后,在进程切换的时候,会修改TTBR0的值,切换到真实的进程地址空间上去。TTBR1用于kernel space,所有的内核线程都是共享一个空间就是swapper_pg_dir。

(3)打开MMU。实际上在这条指令的上下都有isb指令,理论上已经可以turn on MMU之前之后的代码执行顺序严格的定义下来,其实我感觉不必要再启用idmap_pg_dir的那些页表了,当然,这只是猜测。

四、通向start_kernel

我痛恨汇编,如果能不使用汇编那绝对不要使用汇编,还好我们马上就要投奔start_kernel:

__mmap_switched:
adr_l x6, __bss_start
adr_l x7, __bss_stop

1: cmp x6, x7
b.hs 2f
str xzr, [x6], #8 ---------------clear BSS
b 1b
2:
adr_l sp, initial_sp, x4 -----------建立和swapper进程的链接
str_l x21, __fdt_pointer, x5 // Save FDT pointer
str_l x24, memstart_addr, x6 // Save PHYS_OFFSET
mov x29, #0
b start_kernel
ENDPROC(__mmap_switched)

这段代码分成两个部分,一部分是清BSS,另外一部分是为进入c代码做准备(主要是stack)。clear BSS段就是把未初始化的全局变量设定为0的初值,没有什么可说的。要进入start_kernel这样的c代码,没有stack可不行,那么如何设定stack呢?熟悉kernel的人都知道,用户空间的进程当陷入内核态的时候,stack切换到内核栈,实际上就是该进程的thread info内存段(4K或者8K)的顶部。对于swapper进程,原理是类似的:

.set initial_sp, init_thread_union + THREAD_START_SP

如果说之前的代码执行都处于一个孤魂野鬼的状态,“adr_l sp, initial_sp, x4”指令执行之后,初始化代码终于找到了归宿,初始化代码有了自己的thread info,有了自己的task struct,有了自己的pid,有了进程(内核线程)应该拥有的一切,从此之后的代码归属idle进程,pid等于0的那个进程。

为了方便后面的代码的访问,这里还初始化了两个变量,分别是__fdt_pointer(设备树信息,物理地址)和memstart_addr(kernel image所在的物理地址,一般而言是main memory的首地址)。 memstart_addr主要用于main memory中物理地址和虚拟地址的转换,具体可以参考__virt_to_phys和__phys_to_virt的实现。

五、参考文献

1、ARM Architecture Reference Manual

change log:

1、2015-11-30,强调了初始化代码和idle进程的连接

2、2015-12-2,修改了物理空间和虚拟空间的视图

3、2016-9-21,修改对一致性映射的描述

原创文章,转发请注明出处。蜗窝科技

标签:打开MMU

继续讨论

新讨论请用 GitHub 账号在下方发言——评论会保存在本仓库的 Discussions 里,与站点同寿; 再下方的「历史评论」是原站的只读存档。

评论(52 条,只读存档)

以下为原站的历史评论(只读存档);继续讨论请用上方的评论区。

  • passerby

    @linuxer,有个小问题,在汇编中建立的页表是将整个内核都做了映射吗?
    • linuxer

      @passerby:是的,是将整个kernel image进行了映射,开始和结束的定义是: #define KERNEL_START _text #define KERNEL_END _end 当然,和整个内核空间比,这一段实际上也不大的。
      • passerby

        @linuxer:那映射完了,在start_kernel又会做一次page_init映射。这个时候汇编中做的映射会被抛弃掉重新做?不过不是,那这部分page怎么告诉伙伴系统这部分空间已经被占用的?
        • linuxer

          @passerby:那映射完了,在start_kernel又会做一次page_init映射。这个时候汇编中做的映射会被抛弃掉重新做? ------------------------------------ 在start_kernel中不会抛弃”汇编时代“的映射,因为没有必要,都已经建立了又何必毁掉呢。 那这部分page怎么告诉伙伴系统这部分空间已经被占用的? ------------------------------ 伙伴系统其实不需要管理kernel image占用的内存,这是通过arm64_memblock_init函数中的下面代码实现: memblock_reserve(__pa(_text), _end - _text);
          • donkey

            @linuxer:有个问题想请教一下,我最近在看ARM64启动的代码,现在正在研究跳到内核后正式页表的创建流程。在paging_init函数的map_mem函数中会对memory类型的内存创建页表,但是我怎么都找不到memory类型的内存是怎么加到memblock中的。只是在arm64_memblock_init中看到把一些内存区域加到了reserved类型的memblock中,但并没有什么代码把内存加到memory类型的memblock中啊?
            • linuxer

              @donkey:我没有看代码,不过推测是在device tree相关的代码中。
              • donkey

                @linuxer:果然是高手,按照你的提示,我又仔细研究了一下代码流程,发现了这样一条函数调用流程: setup_arch-->setup_machine_fdt-->early_init_dt_scan-->early_init_dt_scan_nodes-->early_init_dt_add_memory_arch-->memblock_add 经过这个流程,感觉memory类型的内存区域就有着落了,呵呵!再次感谢!
              • donkey

                @linuxer:刚才那个流程不知道为什么没显示完全,再补充一下: ...->early_init_dt_add_memory_arch-->memblock_add
  • passerby

    我在paging_init中的map_mem for_each_memblock(memory, reg) { phys_addr_t start = reg->base; phys_addr_t end = start + reg->size; if (start >= end) break; create_mapping(start, __phys_to_virt(start), end - start, false); } 对所有的memblock进行映射,这里就包括了在汇编中映射好的kernel image。
    • linuxer

      @passerby:要回答这个问题,需要理解memory blocks模块(mm/memblock.c文件)。 该模块定义了一个全局变量: struct memblock memblock; 这个全局变量用来管理系统中的所有的memory blocks。这些blocks分成两种: 1、reserved 2、memory 从逻辑上讲,无论那种类型的block,其address region不能是overlap的(因此会有memory region的分裂和合并的操作)。 在函数arm64_memblock_init函数中会调用memblock_reserve(__pa(_text), _end - _text)将kernel image的这段memory region加入“reserved”那种类型的memory blocks。 而你说的for_each_memblock(memory, reg) ,仅仅是遍历“memory”那种类型的memroy blocks。而一旦你reserved了kernel image对应的那一段memory region,它是不会出现在memory类型的blocks中,因此不会再次mapping。 BTW,我非常简单的过了一下memblock.c的代码,很多是从逻辑上推导的,可能有误。
      • passerby

        @linuxer:对于不做mapping有点疑问,因为其他的reserved的内存也需要被做映射啊。比如 91 cont_splash_mem: splash_region@83000000 { 92 linux,reserve-contiguous-region; 93 linux,reserve-region; 94 reg = <0x0 0x83000000 0x0 0x2000000>; 95 label = "cont_splash_mem"; 96 }; kernel image可以不做,但是其他的reserved空间并没有做mapping。在其他地方我并没有看到对reserverd做mapping的地方,只有在这里有看到。
        • linuxer

          @passerby:通过device tree中的reserved-memory节点可以定义若干的reserved memory block,这些保留的memory region基本上被认为是for特定驱动使用的,因此,我的观点是:内核不会进行mapping,使用这些memory的driver应该负责进行mapping。
      • archer

        @linuxer:linuxer你好,reserved的region不会出现在memory类型,这里是不是有误啊? 我看了下,memory类型包括了所有要被线性映射的物理空间,reserved的region只是在reserved类型增加了一个region,但是并没有从memory类型脱离出去。 可以看看__map_memblock这个函数,是来映射一个region的。 它里面先判断了是不是和kernel所在的物理区域有overlap: if (end < kernel_start || start >= kernel_end) { 没有就整个建立映射。
        • linuxer

          @archer:我不是特别明白你的意思,“reserved类型并没有从memory类型脱离出去”这句话是什么意思?你看的是哪个版本的内核?
          • ericzhou

            @linuxer:linuxer你好,我的意思是说,加到reserved的region还在memory类型的范围内。我看的是4.6的内核。 int __init_memblock memblock_reserve(phys_addr_t base, phys_addr_t size) { return memblock_add_range(&memblock.reserved, base, size, MAX_NUMNODES, 0); }
            • linuxer

              @ericzhou:memblock_reserve函数将指定的memory region(reserved type)加到memblock.reserved链表中。而那些memory type的memory region是加到memblock.memory的链表中的,虽然这两种类型的memory region都是在memblock的管理框架中,但是在不同的链表上管理,处理起来也是不一样的。
  • mobz 主页

    Hi linuxer,看到你最近有对系统启动做详细的分析,正好遇到个问题,想请教你下,就是在内核里的函数kernel_execve,有下面这样一段汇编代码,最终将调用到ret_to_user吗?是个什么流程? asm( "add r0, %0, %1\n\t" "mov r1, %2\n\t" "mov r2, %3\n\t" "bl memmove\n\t" /* copy regs to top of stack */ "mov r8, #0\n\t" /* not a syscall */ "mov r9, %0\n\t" /* thread structure */ "mov sp, r0\n\t" /* reposition stack pointer */ "b ret_to_user" : : "r" (current_thread_info()), "Ir" (THREAD_START_SP - sizeof(regs)), "r" (&regs), "Ir" (sizeof(regs)) : "r0", "r1", "r2", "r3", "r8", "r9", "ip", "lr", "memory");
    • linuxer

      @mobz:无论是userspace还是kernel space,都有执行程序的需求。例如在内核空间,当把控制权转交给userspace的时候,需要执行/sbin/init(也有可能是其他程序)。用户空间的使用场景更多,你在terminal上输入某一个程序的命令行的时候,shell程序会fork,然后调用execve来执行程序。 所谓执行某一个二进制程序其实就是内核态的loader将当前进程的地址空间(text,data,bss和stack)销毁,使用新的可执行程序的image来创建新的进程的过程,因此返回调用函数是没有任何意义的(实际上也不存在了)。但是,内核的loader总是要把控制权交给这个新创建的进程,因此,loader在这个新进程的内核栈上模拟了一次陷入内核的过程,在内核栈上构建了一个“现场”,然后调用ret_to_user返回userspace,开始新的进程的执行,当然,CPU的PC值会设定为二进制程序image的入口函数。
      • mobz 主页

        @linuxer:ret_to_user会调用到arch_ret_to_user r1, lr 这里,可是我还是没搞懂这个arch_ret_to_user又是如何实现的?代码中怎么也搜索不到??还是我没看懂。 因为我经常遇到内核启动到Freeing init memory后就卡住的问题.定位发现应该就是卡在返回用户空间来是执行init进程的时候出现的问题,就像类是bootargs设置错误导致 ENTRY(ret_to_user) ret_slow_syscall: disable_irq @ disable interrupts ENTRY(ret_to_user_from_irq) ldr r1, [tsk, #TI_FLAGS] tst r1, #_TIF_WORK_MASK bne work_pending no_work_pending: #if defined(CONFIG_IRQSOFF_TRACER) asm_trace_hardirqs_on #endif /* perform architecture specific actions before user return */ arch_ret_to_user r1, lr restore_user_regs fast = 0, offset = 0 ENDPROC(ret_to_user_from_irq) ENDPROC(ret_to_user)
        • linuxer

          @mobz:我正在读的是4.1.10版本中的ARM64的代码,其中其实都没有kernel_execve这个函数,也没有arch_ret_to_user。 看起来arm平台有arch_ret_to_user的定义,在linux/arch/arm/kernel/entry-common.S文件中: #ifdef CONFIG_NEED_RET_TO_USER #include <mach/entry-macro.S> #else .macro arch_ret_to_user, tmp1, tmp2 .endm #endif
          • mobz 主页

            @linuxer:恩,是的,但是这个是怎么实现从return to userspace的?没看懂只有定义,实现呢?不理解这里
            • linuxer

              @mobz:与其说arch_ret_to_user是architecture specific,不如说是ARM arch下,machine specific。对于有些特殊的arm machine(例如ARCH_IOP13XX),在返回用户空间的时候需要特别的操作,但是对于大部分的ARM处理器,arch_ret_to_user是空的。
              • mobz 主页

                @linuxer:那这么说来,其实从内核到用户空间就是:下面这三条语句(指令)了咯??? disable_irq ldr r1, [tsk, #TI_FLAGS] tst r1, #_TIF_WORK_MASK
              • linuxer

                @linuxer:后面不是有一个restore_user_regs嘛,用于从内核栈恢复userspace的上下文
              • mobz 主页

                @linuxer:在你最新的答复上回复不了,就回复在这里吧,restore_user_regs 这个和arch_ret_to_user在ARM平台上也是一样的,都是空,我并没在代码中找到相关的内容,倒是在FRV平台里找到有
              • linuxer

                @linuxer:在arch/arm/kernel/entry-head.S中有定义(我的内核版本是4.1.10,其他版本应该类似吧)。
  • kitty 主页

    博主真的是辛苦了,像博主这样静下心搞钻研,如此认真隐忍的,太少了。
    • linuxer

      @kitty:不辛苦,如果真心热爱的话就不辛苦,^_^ 喜欢钻研的人很多,只是没有聚合在一起,蜗窝这个网站就是因此而设立的,欢迎每一个沉醉于技术的人。
      • kitty 主页

        @linuxer:hi linuxer,看你写的power相关文章,写的非常详细。但power相关架构,很多要进行调整了,在今年年底,linuro要发布一个新的调度器架构EAS,会把DVFS和cpu idle添加CFS调度器中,而themal也会被IPA机制取代,这是新的研究方向,感兴趣的话,可以一起学习。
  • amusion

    无意中看到了这个网站,拜读了几篇文章后,真是很钦佩啊,文章分析的很深入,不知能否写些和SMP先关的分析
    • linuxer

      @amusion:这位客官,本站暂时不接受“点菜”,呵呵~~~开玩笑的,大家工作都很忙,业余时间写写文章,让自己爽一下,所以,想到哪里写到哪里,SMP的代码分布在各个内核的子系统中,其实不是很好写的。
  • tgn

    请教下博主,内核正式页表中的PXN位一般在哪里设置呀,我看arm64代码里面默认是没有的,能直接在create_mapping函数调用的时候直接把PAGE_KERNEL_EXEC给或上一个PXN吗? 我是用的4.5的内核
    • linuxer

      @tgn:为何要给PAGE_KERNEL_EXEC加上一个PXN的flag?PAGE_KERNEL_EXEC应该对应内核可执行代码的那些memory,因此创建页表的时候没有PXN是合适的,如果置位PXN,那么你的意思是准备让它在特权模式下永远不执行(Privileged execute-never)?
  • archer

    linuxer,你好,请教一个问题: PAGE_OFFSET开始的虚拟地址 会 映射到PHYS_OFFSET的物理地址 (线性区), PHYS_OFFSET的定义: #define PHYS_OFFSET ({ VM_BUG_ON(memstart_addr & 1); memstart_addr; }) 这个memstart_addr的全局变量是在arm64_memblock_init这个函数中计算确定的。 所以线性区的起始物理地址是在这里才确定的? 我的问题:因为内核的虚拟地址在PAGE_OFFSET的0x80000偏移处,所以Image物理地址也应该在memstart_addr的0x80000偏移处? 但是memstart_addr是在这里才计算确定的,bootloader是怎么知道要把Image加载到这里的呢?
    • linuxer

      @archer:这个memstart_addr的全局变量是在arm64_memblock_init这个函数中计算确定的。 所以线性区的起始物理地址是在这里才确定的? ------------------- 我看的是4.4.6内核,memstart_addr是在内核启动的初始阶段被设定的: ENTRY(stext) ...... adrp x24, __PHYS_OFFSET ...... 之后,在__mmap_switched函数中: str_l x24, memstart_addr, x6 // Save PHYS_OFFSET mov x29, #0 因为内核的虚拟地址在PAGE_OFFSET的0x80000偏移处,所以Image物理地址也应该在memstart_addr的0x80000偏移处? -------------- 是的 但是memstart_addr是在这里才计算确定的,bootloader是怎么知道要把Image加载到这里的呢? --------------- 这些内容本来就是bootloader和kernel之间接口的一部分,bootloader本来就知道应该copy kernel image到哪里的,如果不知道,系统就没有办法运作了。
      • ericzhou

        @linuxer:linuxer,thanks for your reply. 我看得是4.6的内核,memstart_addr的计算确定过程有点变化。 是在arm64_memblock_init这个函数里确定的。 不过你的意思我明白了。谢谢。
  • macooma

    博主的文章对于我这样初学armv8的晚辈来讲真是提供了极大的参考啊,感谢博主的无私精神! 有个问题想请教一下,如下: idmap_pg_dir是为turn on MMU准备的一致性映射,物理地址的高16bit都是0,因此identity mapping必定是选择TTBR0_EL1指向的各级地址翻译表。 ------------------------------------------------------------------------------------- 请问这里的“必定”是因何而来呢? 谢谢!
    • linuxer

      @macooma:identity mapping实际上是把 物理地址映射到物理地址上去,ARMv8支持的物理地址最大是48个bit,因此高16bit必定等于0
      • macooma

        @linuxer:意思是CPU会主动判断要转换的地址前16位来决定使用TTBR0还是TTBR1吧?
        • thatman

          @macooma:请问下。这个问题有答案了吗?
  • breeze

    @linuxer: 本来我以为memblock是在arm64_memblock_init()中初始化的,但我发现kernel在call arm64_memblock_init()之前就已经初始化过memblock一次了. 如:我在arm64_memblock_init()的入口处调用memblock_dump_all(), 输出如下: MEMBLOCK configuration: memory size = 0xf0000000 reserved size = 0x0 memory.cnt = 0x1 memory[0x0] [0x00000010000000-0x000000ffffffff], 0xf0000000 bytes flags: 0x0 reserved.cnt = 0x1 reserved[0x0] [0x00000000000000-0xffffffffffffffff], 0x0 bytes flags: 0x0 至少memblock.memory已经初始化过了,region为: [0x00000010000000-0x000000ffffffff]. 请问楼主您知道是在哪里初始化的吗?我百思不得其姐. 谢谢.
    • wowo

      @breeze:你可以检查一下是不是这里初始化的(dts文件中指定的memblock): setup_arch setup_machine_fdt early_init_dt_scan_memory early_init_dt_add_memory_arch memblock_add
  • leba

    实际上在这条指令的上下都有isb指令,理论上已经可以turn on MMU之前之后的代码执行顺序严格的定义下来,其实我感觉不必要再启用idmap_pg_dir的那些页表了,当然,这只是猜测。 ------ 应该还与 pipeline 有关系,所以,那个 idmap 还是需要的。
    • linuxer

      @leba:你说得有道理,看来还需要再深入理解一下CPU的架构。
    • 2freeman 主页

      @leba:idmpa_pg_dir在MMU开启后应该还是需要的,无论是否跟pipeline有关,在MMU开启后,VA=PA=xxxx,所以,对于这样的VA,MMU的翻译还是需要使用idmap_pg_dir页表,只有在VA不再等于PA,也就是不再是一致性映射时,idmap_pg_dir页表才真正失效。而VA不等于PA的点,应该在__primary_switch中:ldr x8, =__primary_witched;br x8,x8里保存的是真正的VA(!=PA),在br指令执行后,完成了VA(=PA)--> VA(!=PA)的转换,这是才是idmap_pg_dir不再起作用的时间点,这也许是这个函数为什么叫__primary_witched的原因。
  • rikeyone

    你好,linuxer: 我想请教一下,在start kernel之前创建的页表应该只是临时页表,那么在start kernel中的setup arch中会重新创建内核页表的映射,那么已经运行在虚拟空间上了,这个映射是怎么切换的呢?
    • rikeyone

      @rikeyone:我看的是arm32的内核操作,里面会调用pmd clear清除一级页表的内容
  • see

    请教下,文档里说编译后的内核运行在0xFFFF8000_00080000? 但是通过readelf查看内核,入口点地址是0xffff000008080000,怎么和文档说法不一致?
    • smcdef

      @see:可能你的内核代码已经把kernel从linear mapping区域搬移到vmalloc区域了。所以造成了这种现象。详情可以看下另外一篇文档:ARM64 Kernel Image Mapping的变化:/memory_management/436.html
  • daiyinger

    博主你好,我目前遇到个开启mmu之后处理器变慢的问题,请问可能是什么原因呢 ldr x1, =0xf0000000 str x0,[x1] br x27 ENDPROC(__enable_mmu) 我是4核A53处理器,我在用其中一个核来引导另一个内核,如上我打算在开启mmu之后往0xf0000000物理地址写特征值表征mmu已开启,发现要等很久(几十秒)才发现0xf0000000的值被改写,如果代码放到开启mmu之前就不会。
    • daiyinger

      @daiyinger:最后发现是cache不一致的问题导致的
    • llp

      @daiyinger:请问你这个物理地址在mmu enable 之后,是如何映射的